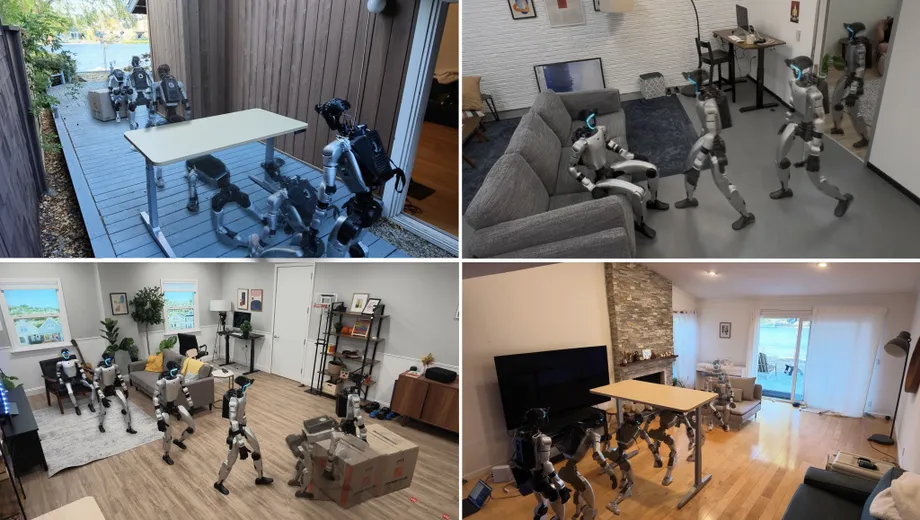
Un robot entraîné dans des logements virtuels s’attaque à de vraies pièces
Des chercheurs d’Apple affirment que leur système de contrôle humanoïde HALO a accompli des tâches physiques individuelles avec un taux de réussite moyen de 91 % sur 360 essais, dans six environnements réels qui n’avaient jamais été scannés ni cartographiés. Fonctionnant sur un Unitree Robotics G1, le système a mis à profit les enseignements tirés de la simulation pour se déplacer dans des espaces inconnus, s’asseoir sur des meubles, franchir des ouvertures étroites et pousser des boîtes.
Sommaire
- Un robot entraîné dans des logements virtuels s’attaque à de vraies pièces
- Ce que recouvre le résultat de 91 %
- Pourquoi les consignes longues sont plus difficiles
- Trois couches transforment une consigne en mouvement
- Un Mac mini embarqué sur le G1
- Comment 1 000 maisons virtuelles fournissent des exemples d’entraînement
- Le coût informatique et le travail humain
- La vision ne résout pas encore les problèmes de contact
- Ce que ces travaux changent
- Points clés
Les résultats sont présentés dans Perceptive Humanoid Motion from Simulation, une étude soumise à arXiv le 4 novembre 2026. L’article de l’équipe d’Apple décrit un entraînement reposant sur environ 300 heures d’exemples synthétiques générés dans 1 000 environnements domestiques conçus par ordinateur, avant le transfert direct du système vers un robot physique.
Les tâches plus longues se sont révélées plus difficiles. Dans un environnement réel distinct, HALO a obtenu un taux de réussite moyen de 70 % pour trois enchaînements d’actions, chacun tenté 10 fois. La séquence qui lui demandait de passer sous un obstacle, de s’approcher d’une cible puis de pousser une boîte a réussi cinq fois sur 10.
L’avancée concrète réside dans le lien établi entre la compréhension d’une demande et le déplacement de tout un corps dans un espace encombré de meubles inconnus. Une consigne comme s’asseoir sur une chaise oblige le robot à repérer l’assise, à trouver un itinéraire, à positionner son corps et à garder l’équilibre en s’abaissant. HALO répartit ces responsabilités entre trois couches de contrôle qui coopèrent.
Les auteurs sont Siyuan Hu, Abulikemu Abuduweili, Yue Meng, Shipeng Liu, Quentin Leboutet, Chen Chen, Matthias Müller et Vladlen Koltun, tous affiliés à Apple. Ils ont également publié le code couvrant la génération des données, l’entraînement et le déploiement, notamment la planification des tâches, la génération des mouvements et leur suivi en simulation et sur des robots physiques.
Ce que recouvre le résultat de 91 %
Les taux de réussite varient selon les six aptitudes évaluées. L’accroupissement obtient le meilleur résultat, tandis que s’asseoir est l’action la moins bien réussie :
- Se rendre auprès d’un objet désigné : 92 %.
- S’asseoir sur un meuble : 85 %.
- Passer par une porte entrouverte : 93 %.
- S’accroupir sous un obstacle : 100 %.
- Ramper sous un obstacle : 90 %.
- Pousser une boîte : 88 %.
L’écart entre l’accroupissement et la position assise est de 15 points de pourcentage. S’asseoir ne consiste pas seulement à atteindre le bon endroit : le robot doit s’aligner sur le meuble et transférer son poids sur l’assise. Cela sollicite à la fois sa compréhension visuelle et son contrôleur physique.
Les six environnements d’évaluation étaient inconnus de HALO. Les chercheurs ne les avaient ni scannés au préalable ni utilisés pendant l’entraînement. L’article parle de transfert « zero-shot » : le système est passé de l’entraînement simulé à ces environnements physiques sans entraînement supplémentaire propre à chacun d’eux.
Des démonstrations montrent également le G1 suivre une personne, s’asseoir sur un canapé, se déplacer de côté pour franchir une porte entrouverte et se baisser ou ramper sous une table. Ces mouvements illustrent la façon dont le système adapte sa posture à l’espace qui l’entoure, au lieu de simplement marcher vers une destination.
Pourquoi les consignes longues sont plus difficiles
Les résultats varient davantage pour les trois enchaînements de tâches de HALO. Le robot a réussi les 10 essais où il devait franchir une porte puis se rendre auprès d’une cible. Il a réussi six essais sur 10 pour l’enchaînement consistant à s’accroupir puis à s’asseoir. Pour s’accroupir, s’approcher d’une cible et pousser une boîte, il a réussi cinq essais sur 10.
Au total, 21 séquences sur 30 ont réussi, soit 70 %. C’est 21 points de pourcentage de moins que la moyenne des tâches individuelles, même si les tests en séquence se sont déroulés dans un contexte différent et portaient sur un nombre plus restreint d’essais.
Une séquence multiplie les occasions de rencontrer un problème, car chaque mouvement détermine la position de départ du suivant. En sortant de sous un obstacle, par exemple, le robot doit se retrouver dans une position qui lui permette d’approcher sa cible et d’effectuer le mouvement suivant.
HALO s’appuie sur des vérifications visuelles. Son planificateur analyse la vidéo captée du point de vue du robot, évalue si l’action en cours a réussi et décide de passer à la suite ou de réessayer. Les résultats montrent qu’enchaîner des aptitudes utiles reste plus difficile que de les exécuter séparément.
Trois couches transforment une consigne en mouvement
La couche de contrôle supérieure gère la planification des tâches. Elle utilise un modèle vision-langage, un type d’IA qui traite à la fois les images et les mots, pour interpréter une consigne en fonction de ce que voit la caméra. Le modèle utilisé par défaut est Qwen3.6-35B-A3B ; il fonctionne localement sur un Mac mini transporté par le robot.
Le planificateur est sollicité toutes les deux secondes. Si quelqu’un demande au robot de s’asseoir sans préciser sur quel siège, celui-ci doit choisir un objet adapté dans son champ de vision. Si une table bloque le chemin vers une chaise, il peut décomposer la consigne en actions plus simples : se baisser pour passer sous l’obstacle, s’approcher de la chaise puis s’asseoir.
La couche intermédiaire transforme chaque sous-tâche en plan de mouvement. Elle combine Qwen3.5-2B, dont les paramètres d’encodeur restent fixes pendant l’entraînement, avec un décodeur de type transformeur de diffusion qui génère des mouvements du corps entier. Un encodeur convertit l’image et la consigne en une représentation exploitable par le modèle de mouvement ; le décodeur produit les poses prévues.
Cette couche anticipe les mouvements sur environ cinq secondes et recalcule son plan à peu près trois fois par seconde. Elle actualise donc continuellement les mouvements prévus à partir de nouvelles images de la caméra, au lieu de lancer une action de cinq secondes sans vérifier son environnement.
La couche inférieure, appelée « suiveur de mouvement », convertit ces plans en commandes articulaires 50 fois par seconde. Elle combine des images de profondeur avec des informations sur la position et les mouvements du robot, afin de l’aider à suivre le plan tout en tenant compte de son équilibre, des contacts et des limites de ses moteurs.
Un Mac mini embarqué sur le G1
Dans la configuration physique, un Mac mini doté d’une puce M4 Pro et de 64 Go de mémoire unifiée est installé dans un boîtier de protection sur le dos du G1. Cet ordinateur exécute les modèles les plus exigeants de planification des tâches et de génération des mouvements. Le processeur embarqué du G1 fait tourner le suiveur de mouvement.
Une caméra OAK-1W est fixée sur un support conçu sur mesure pour la tête du robot. Son flux vidéo couleur offre une résolution de 1 280 × 800 pixels, une fréquence de 30 images par seconde et un champ de vision de 120 degrés. Cet angle large aide le système à observer les meubles et les ouvertures proches pendant les déplacements du robot.
Le robot fonctionne sans être relié à un câble, ses composants logiciels communiquant par ZeroMQ, un système de messagerie. Sa configuration locale par défaut peut fonctionner sans connexion Internet. HALO peut également faire appel à un modèle dans le cloud via une interface de programmation d’application, si cette option est configurée.
La répartition du calcul correspond à la hiérarchie de contrôle. La compréhension d’une consigne peut avoir lieu moins fréquemment, tandis que stabiliser un robot en mouvement exige des mises à jour bien plus rapides. Le générateur de mouvements calcule un nouveau plan pendant que le suiveur exécute le plan en cours, ce qui évite un arrêt à chaque calcul du modèle.
Comment 1 000 maisons virtuelles fournissent des exemples d’entraînement
Le pipeline d’entraînement de HALO s’attaque à un manque précis : celui d’exemples qui relient ce qu’un humanoïde voit, ce qu’on lui demande de faire et la façon dont son corps entier doit bouger. Les vidéos ordinaires montrent des images d’actions, mais l’entraînement de ce système nécessite d’associer ces images à des consignes et à des mouvements détaillés du robot.
Les auteurs décrivent le temps nécessaire à certaines méthodes qui recueillent des démonstrations par téléopération humaine ou au moyen de dispositifs d’enregistrement portés par des personnes :
Puisqu’une personne doit réaliser manuellement chaque séquence, une heure de données coûte au moins une heure de travail humain.
HALO génère plutôt des exemples associés en simulation. Le processus commence par une tâche divisée en segments de mouvement. S’asseoir dans un fauteuil peut, par exemple, impliquer d’avancer, de se retourner puis de s’asseoir. Des consignes textuelles, des points de passage et des poses clés guident un modèle de génération de mouvements appelé Kimodo.
Des vérifications géométriques automatisées évaluent ensuite les mouvements proposés afin de repérer des problèmes tels que les pieds qui glissent, les corps qui traversent le sol, les sauts brusques et les articulations qui dépassent leurs limites. Le pipeline conserve le meilleur mouvement avant de le placer dans une pièce virtuelle.
Infinigen, un générateur de scènes procédural, fournit 1 000 environnements aux plans et aux meubles variés, dont des salons, des bureaux et des chambres. Le système recherche les configurations dans lesquelles le mouvement prévu du robot et l’objet ciblé tiennent sans entrer en collision avec les meubles environnants.
Un simulateur restitue ensuite ce que le robot verrait en effectuant l’action, à l’aide d’une caméra fisheye simulée correspondant à la configuration physique. Les variations d’éclairage, d’exposition, de couleur, de contraste, de flou et de bruit du capteur diversifient les images. Chaque exemple obtenu associe une consigne, une image de caméra et le mouvement corporel correspondant.
Le coût informatique et le travail humain
La génération du principal corpus d’entraînement a pris environ 48 heures sur 250 processeurs graphiques Nvidia H100. Ces processeurs, communément appelés GPU, effectuent de nombreux calculs en parallèle, ce qui permet de produire simultanément de grandes quantités de données simulées.
Le générateur d’actions a été entraîné par imitation à l’aide de 64 GPU Nvidia B200. Dans l’apprentissage par imitation, un modèle apprend à reproduire des comportements présentés en exemple. Le suiveur de mouvement a été entraîné sur quatre GPU H100 avec une méthode combinant apprentissage par renforcement et distillation de politique.
L’apprentissage par renforcement entraîne un contrôleur par essais et retours sur la qualité de ses performances. La distillation de politique transfère un comportement appris vers un autre modèle. Dans HALO, ces méthodes aident le suiveur à convertir les poses prévues en mouvements que le robot physique peut exécuter.
Les humains définissent toujours certaines parties du processus. L’ajout d’une nouvelle tâche physique nécessite de rédiger des consignes et de concevoir des poses clés, et certains mouvements s’appuient sur des vidéos humaines ou des données de capture de mouvement. Une fois les descriptions de tâches et les contraintes établies, le pipeline peut les réutiliser dans de nombreuses pièces générées.
Le changement porte donc sur la manière de multiplier les démonstrations. Au lieu de demander à une personne d’effectuer chaque séquence, HALO mobilise des ressources informatiques pour générer et vérifier de nombreuses variantes d’une tâche.
La vision ne résout pas encore les problèmes de contact
Selon les chercheurs, HALO s’appuie principalement sur la vision et ne peut pas percevoir directement les contacts. Ses performances peuvent baisser pendant les tâches impliquant des contacts physiques importants, lorsqu’un objet sort du champ de la caméra ou est masqué par un autre.
Le fait de pousser une boîte montre pourquoi cela importe. Le robot doit rester correctement positionné par rapport à la boîte pendant que tous deux se déplacent. Une caméra fournit des informations sur la position visible, tandis que le sens du toucher pourrait renseigner sur le contact, même lorsque la vue est obstruée.
Les chercheurs citent la perception tactile parmi les pistes possibles pour les travaux futurs, sans préciser de calendrier pour son intégration. Les résultats actuels délimitent clairement le défi : HALO peut exécuter plusieurs gestes guidés par la vision dans des pièces inconnues, mais les longues séquences et les interactions impliquant un contact restent moins fiables.
Ce que ces travaux changent
L’étude d’Apple réunit la génération de données d’entraînement, la planification à partir du langage et le contrôle physique au sein d’un système qui fonctionne sur un humanoïde dans des pièces qu’il n’a jamais vues auparavant. Son résultat le plus marquant est le transfert de 1 000 environnements simulés à 360 essais physiques, sans cartographie préalable des six lieux de test.
Le code publié met ce pipeline à la disposition d’autres recherches, en simulation comme sur du matériel physique. Il comprend les outils de génération des exemples d’entraînement ainsi que les modèles et logiciels nécessaires pour générer, suivre et coordonner les mouvements.
Pour quelqu’un qui demande à un robot de s’asseoir ou de déplacer une boîte, la fiabilité dépend du bon fonctionnement de toute la chaîne : reconnaître le bon objet, l’atteindre, entrer en contact avec lui et terminer le mouvement. Les résultats obtenus par HALO sur des tâches individuelles témoignent de progrès à chacune de ces étapes. Ceux des enchaînements montrent où des travaux supplémentaires sont nécessaires avant de pouvoir combiner plusieurs actions avec la même régularité.
Points clés
- Des chercheurs d’Apple ont soumis Perceptive Humanoid Motion from Simulation à arXiv le 4 novembre 2026.
- HALO a atteint un taux de réussite moyen de 91 % sur 360 essais de tâches individuelles, dans six environnements réels inconnus et non cartographiés.
- Trois enchaînements de tâches ont obtenu un taux de réussite moyen de 70 % sur 30 essais, dans un autre environnement réel.
- Le système combine la planification des tâches, la génération des mouvements et un suiveur qui envoie des commandes articulaires 50 fois par seconde.
- L’entraînement a utilisé environ 300 heures d’exemples synthétiques répartis dans 1 000 environnements générés.
- Un Mac mini transporté par le Unitree G1 permet un fonctionnement local sans connexion Internet.
- La conception des tâches fait toujours appel à des humains et les capacités limitées de perception des contacts restent un point faible.