Une même recette de fabrication pour trois fournisseurs de mémoire
Nvidia a demandé à Samsung Electronics, SK hynix et Micron d’utiliser le procédé de fabrication 3 nm de TSMC pour les dies de base de sa prochaine génération de mémoire à large bande passante personnalisée, selon des informations publiées par des sources du secteur le 18 octobre 2026. La division Device Solutions de Samsung aurait accepté cette demande après un examen interne, faisant ainsi appel à son concurrent taïwanais dans un domaine de la fabrication de mémoire que Samsung prenait traditionnellement en charge en interne.
Sommaire
- Une même recette de fabrication pour trois fournisseurs de mémoire
- Qu’est-ce qui change dans la pile mémoire ?
- Pourquoi Nvidia veut un procédé commun aux fournisseurs
- Samsung conserve ses propres usines dans l’équation
- Micron et SK hynix adoptent des voies différentes
- Ce que signifient les chiffres de performance de Nvidia
- Amazon relie la mémoire à l’écosystème plus large de Nvidia
- Comment la transition s’est développée
- Points clés
Le produit, appelé NVHBM, repose sur la HBM4E, la septième génération de mémoire à large bande passante. Nvidia souhaite également que les fournisseurs utilisent la sixième génération de technologie de fabrication de DRAM pour les dies mémoire, désignée sous le nom de 1c. L’objectif est d’assurer un comportement plus homogène des mémoires de différents fournisseurs et de réduire le travail d’ingénierie nécessaire à l’homologation des produits de chacun.
La décision de Samsung étendrait sa relation existante avec TSMC, de la compatibilité avec les technologies de packaging à la fabrication de HBM. Quatre ans plus tôt, les deux entreprises avaient collaboré pour garantir que la mémoire Samsung puisse se connecter aux processeurs graphiques par l’intermédiaire de la technologie de packaging de TSMC. La fabrication d’une puce essentielle à l’intérieur de la pile mémoire approfondit cette coopération.
La proposition de Nvidia modifie également le rôle du die de base. Avec la NVHBM, le contrôleur mémoire, qui dirige les flux de données, passe du processeur principal au bas de la pile mémoire. Le die de base devient ainsi un élément plus important du système informatique, au lieu de servir simplement de liaison entre la mémoire et le processeur.
Pour Samsung, accepter cette architecture revient à dissocier deux décisions jusqu’ici prises ensemble : qui fabrique la mémoire qui stocke les informations, et qui produit la puce logique qui gère sa connexion au processeur. Samsung continuerait à fournir la mémoire, tandis que TSMC fabriquerait le die de base spécifié.
Qu’est-ce qui change dans la pile mémoire ?
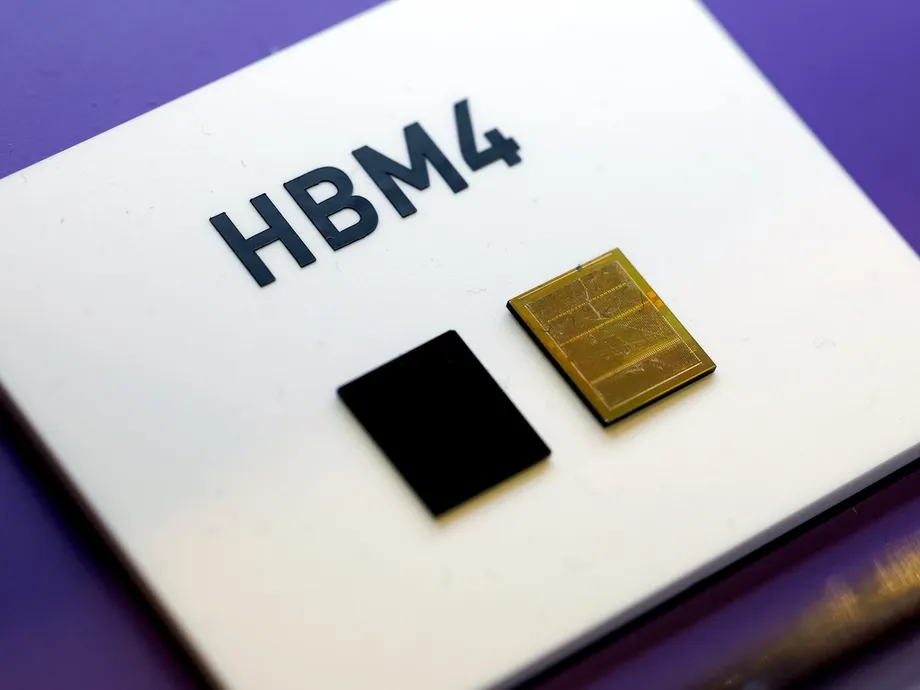
La HBM empile plusieurs dies mémoire les uns sur les autres, à côté d’un processeur puissant. Cette conception permet à de grandes quantités de données de circuler sur de courtes distances, ce qui aide les accélérateurs d’IA à alimenter leurs unités de calcul en informations. Un die est un morceau individuel de silicium contenant des circuits électroniques.
Les dies principaux stockent les données. Le die de base se trouve en dessous et gère les connexions ainsi que les fonctions logiques. Dans une configuration conventionnelle, le contrôleur mémoire reste sur le die de l’accélérateur principal. La NVHBM déplace ce contrôleur dans le die de base, libérant de l’espace sur le processeur pour d’autres circuits.
Nvidia utilise également une interface physique personnalisée, appelée PHY, pour connecter les puces. La PHY est le circuit qui émet et reçoit les signaux électriques. Selon les descriptions techniques de la NVHBM, elle remplace la large interface parallèle associée à la HBM standard par une connexion série propriétaire plus étroite, qui transmet les données par un plus petit nombre de connexions à vitesse plus élevée.
L’ampleur de l’interface conventionnelle permet de comprendre l’intérêt de cette évolution. La HBM4 comporte 32 canaux de 64 bits chacun, soit une largeur totale de 2 048 bits. La gestion de ces connexions exige des circuits conséquents et un câblage complexe entre les puces. La NVHBM vise à réduire cette charge et à simplifier le routage sur l’interposeur, la couche de connexion située sous les puces.
Nvidia propose la NVHBM comme brique de base aux partenaires de conception de puces personnalisées dans le cadre de NVLink Fusion. La HBM standard reste une catégorie de produits distincte. Les partenaires qui choisissent la NVHBM utiliseraient le contrôleur et la conception de connexion spécifiés par Nvidia dans leurs propres systèmes d’accélération.
Pourquoi Nvidia veut un procédé commun aux fournisseurs
La recette de fabrication proposée par Nvidia associe le procédé logique 3 nm de TSMC à des procédés DRAM avancés pour les couches mémoire. La logique et la DRAM remplissent des fonctions différentes et reposent sur des méthodes de fabrication distinctes. La désignation 3 nm identifie une génération de fabrication logique, tandis que 1c désigne une génération de technologie DRAM.
Samsung, SK hynix et Micron ont chacun leurs propres conceptions et méthodes de production. Ces différences peuvent nécessiter des essais supplémentaires lorsqu’un concepteur d’accélérateurs souhaite acheter de la mémoire auprès de plusieurs entreprises. Un procédé commun pour le die de base offre aux concepteurs un point de départ plus homogène.
L’homologation consiste à vérifier que le processeur, la mémoire et le boîtier fonctionnent ensemble à la vitesse, au niveau de consommation et avec la fiabilité visés. Répéter ce travail pour différentes mises en œuvre mobilise du temps d’ingénierie. La proposition de Nvidia vise à réduire le volume de travaux d’intégration distincts nécessaires lorsqu’on change de fournisseur de mémoire.
Micron appelle sa prochaine génération de DRAM 1-gamma, une désignation globalement comparable à la génération 1c dans la terminologie de Samsung et de SK hynix. Un objectif unifié réunit donc des générations de fabrication portant des noms différents selon les entreprises, sans pour autant rendre identiques les procédés mémoire de tous les fournisseurs.
TSMC deviendrait un partenaire de fabrication commun pour des produits mémoire concurrents. Cette organisation pourrait simplifier la mise en œuvre de Nvidia auprès de différents fournisseurs, tout en concentrant une étape de production importante dans une seule fonderie. L’étude par Samsung d’une solution de fabrication de secours témoigne de l’importance concrète de garantir un approvisionnement suffisant en dies de base.
Samsung conserve ses propres usines dans l’équation
Samsung prévoit de conserver son modèle de fabrication intégrée pour la HBM standard. Ses produits HBM4 et HBM4E utilisent son propre procédé 4 nm pour le die de base et son procédé 1c pour les dies principaux. Les couches mémoire sont fabriquées sur ses sites de Hwaseong et de Pyeongtaek, en Corée du Sud.
Samsung a lancé la production en masse de la HBM4 plus tôt en 2026, tandis que la HBM4E était en cours d’homologation en vue de sa production en masse au moment des informations publiées en octobre. L’homologation est l’étape d’essais qui permet d’établir si un produit peut être fabriqué de façon régulière selon les normes requises.
La HBM personnalisée destinée à d’autres clients, dont AMD, devrait également conserver l’approche intégrée de Samsung. La décision relative à la NVHBM concerne donc spécifiquement les exigences de Nvidia et ne marque pas un abandon généralisé de la fabrication interne des dies de base par Samsung.
La division Memory Business de Samsung devrait prendre en charge la conception et l’optimisation des dies de base fabriqués par TSMC. Cela modifierait la répartition des responsabilités au sein de Samsung, où System LSI et l’activité Foundry contribuaient traditionnellement aux dies de base produits en interne.
Samsung étudie également la possibilité que sa propre fonderie fabrique les dies de base de la NVHBM si la demande dépasse les capacités de TSMC. Cette solution de secours préserverait une autre option de production, même si la spécification Nvidia rapportée repose actuellement sur le procédé 3 nm de TSMC.
Micron et SK hynix adoptent des voies différentes
Le changement de Micron dépasse le cadre du produit personnalisé de Nvidia. L’entreprise indique que la NVHBM, développée avec Nvidia, et sa HBM4E standard utiliseront toutes deux des dies de base fabriqués par une fonderie externe. TSMC devrait se charger de cette fabrication.
Pour la HBM4, Micron associe des dies mémoire fabriqués selon son procédé 1-beta à un die de base produit en interne. Avec la HBM4E, les couches mémoire passent au procédé 1-gamma et la production du die de base est externalisée. Micron modifie donc les deux principales parties de la pile : il adopte un procédé mémoire plus récent et fait appel à un partenaire externe pour la fabrication logique.
Manish Bhatia, directeur des opérations de Micron, s’attend à ce que la NVHBM se vende à un prix moyen plus élevé et dégage des marges plus importantes. Il estime que la HBM se vend déjà à un prix supérieur, et que le travail et les fonctions supplémentaires liés à la personnalisation créent davantage de valeur. L’externalisation du die de base peut donc aller de pair avec une attente de rentabilité accrue.
SK hynix utilise déjà le procédé logique 12 nm de TSMC pour les dies de base de la HBM4. Selon des informations du secteur, le procédé 3 nm de TSMC est réservé en priorité à la HBM4E et aux futures mémoires HBM personnalisées. Cette évolution apporterait une fabrication logique plus avancée à un composant appelé à assumer davantage de responsabilités.
SK hynix a également présenté un concept de HBM personnalisée reposant sur sa technologie Stream DQ lors de l’événement GTC de Nvidia, plus tôt dans l’année. Ce concept vise à gérer et à acheminer les données en continu vers les processeurs. Chez les trois fournisseurs, la tendance commune consiste à faire du die de base un acteur plus actif dans le transfert des données.
Ce que signifient les chiffres de performance de Nvidia
Nvidia affirme que la NVHBM peut offrir jusqu’à 30 % de bande passante supplémentaire par pile par rapport à la HBM4E standard et consommer 15 % d’énergie HBM en moins. La bande passante mesure la quantité de données pouvant être transférée pendant une durée donnée. Une bande passante plus élevée peut être utile à un processeur d’IA en attente de données provenant de la mémoire.
À titre de comparaison simple, si une pile HBM4E standard fournit 100 unités de données pendant une période donnée, l’amélioration maximale revendiquée par Nvidia porterait ce chiffre à 130 unités. Si la mémoire de référence consomme 100 unités d’énergie, la réduction annoncée ramènerait la consommation HBM à 85 unités. Ces exemples illustrent les pourcentages, sans décrire des produits spécifiques commercialisés.
Nvidia évoque également une libération pouvant atteindre 25 % de la surface du die de calcul XPU. XPU est un terme générique désignant un processeur informatique, notamment les accélérateurs d’IA personnalisés. Éloigner les circuits mémoire permet aux concepteurs de consacrer une plus grande partie du silicium aux fonctions de calcul.
Un autre compte rendu de la présentation de Nvidia avance un gain de calcul pouvant atteindre 30 % sur le die principal. Ce chiffre mesure les ressources de calcul potentielles, tandis que celui de 25 % correspond à la surface de silicium libérée par le changement d’architecture. Les concepteurs doivent encore décider comment utiliser l’espace récupéré.
Selon les descriptions, la PHY personnalisée réduit jusqu’à 67 % la surface occupée par l’interface. Une évaluation technique établit cette estimation à partir de la réduction du nombre de broches. Les comparaisons plus générales de Nvidia concernant la bande passante, la consommation et la surface prennent pour référence la HBM4E standard, alors que cette génération n’était pas encore commercialisée.
Pour un service d’IA, un transfert de données plus rapide peut accélérer la génération des réponses lorsque la mémoire constitue le facteur limitant. Une consommation mémoire réduite peut donner aux concepteurs de systèmes davantage de marge dans leur budget électrique. L’effet sur un serveur complet dépend aussi du processeur, de la charge de travail, du réseau et du refroidissement, ainsi que de la mémoire.
Amazon relie la mémoire à l’écosystème plus large de Nvidia
Annapurna Labs, filiale d’Amazon, est le premier partenaire annoncé pour la NVHBM. Cette activité de conception de puces développe les accélérateurs Trainium d’Amazon Web Services, ce qui permet à Nvidia de fournir sa technologie mémoire à une entreprise qui conçoit également ses propres processeurs d’IA.
Nafea Bshara, vice-président d’Annapurna Labs, a décrit l’objectif du partenariat dans des commentaires accompagnant l’annonce :
Nous nous réjouissons de cette collaboration technologique, qui profitera à la conception des futures infrastructures AWS.
Le Trainium 4 d’Annapurna devrait prendre en charge NVLink Fusion. Selon les informations sur le déploiement de la NVHBM, son introduction pourrait avoir lieu avec le Trainium 4 ou une génération ultérieure ; la génération exacte de puce et la date de disponibilité commerciale de la mise en œuvre de la NVHBM par Amazon n’ont pas été publiquement établies.
NVLink Fusion donne aux partenaires accès à des technologies comme NVLink Chiplet, NVLink-C2C, NVLink Switch, ainsi qu’aux systèmes et racks MGX. Ces solutions fournissent des interconnexions et des conceptions système permettant d’intégrer des processeurs personnalisés à l’infrastructure informatique de Nvidia. La NVHBM ajoute le sous-système mémoire à cet ensemble.
Selon certaines informations, MediaTek a adopté NVLink Fusion cinq jours après l’annonce de la NVHBM et prévoyait de le proposer à ses propres clients XPU. Nvidia dispose ainsi d’une autre voie d’accès aux projets d’accélérateurs personnalisés, un marché où Broadcom et Marvell sont également présents. Marvell avait décrit en décembre 2024 une approche comparable consistant à déplacer le contrôle mémoire, ce qui fait de l’adoption par les clients et de l’intégration système des enjeux importants de la concurrence.
Comment la transition s’est développée
Le développement de la NVHBM réunit des changements d’architecture, de relations avec les fournisseurs et d’adoption par les clients. La chronologie permet de comprendre l’importance de la décision prise par Samsung en octobre : Nvidia a d’abord présenté la conception commune, puis les fabricants de mémoire ont dû décider comment la produire.
- Décembre 2024 : Marvell présente un concept comparable qui prévoit une autre répartition des fonctions de contrôle mémoire.
- Plus tôt en 2026 : Samsung lance la production en masse de la HBM4, tandis que SK hynix présente son concept de HBM personnalisée Stream DQ lors du GTC.
- 26 août 2026 : Nvidia annonce la NVHBM comme un ajout à NVLink Fusion et désigne Annapurna Labs comme premier partenaire.
- Cinq jours plus tard : selon certaines informations, MediaTek adopte NVLink Fusion et prévoit de le proposer à ses clients XPU.
- 18 octobre 2026 : des sources du secteur rapportent que Nvidia demande des dies de base fabriqués selon le procédé 3 nm de TSMC et que Samsung accepte après un examen interne.
La décision de Samsung rapproche le plan de fabrication de l’objectif de Nvidia : assurer une mise en œuvre cohérente chez les différents fournisseurs de mémoire. Dans le même temps, les investissements que Samsung poursuit dans ses propres dies de base préservent une autre voie pour la HBM standard et les produits personnalisés destinés à d’autres clients.
Points clés
- Nvidia souhaiterait, selon certaines informations, que Samsung, SK hynix et Micron utilisent le procédé 3 nm de TSMC pour les dies de base de la NVHBM.
- La NVHBM déplace le contrôleur mémoire du processeur principal vers le die de base de la pile HBM.
- Samsung a accepté la demande, mais prévoit de conserver la fabrication interne pour la HBM standard et d’autres produits personnalisés.
- Micron prévoit d’externaliser la fabrication des dies de base pour la NVHBM et la HBM4E standard ; SK hynix collabore déjà avec TSMC sur la HBM4.
- Nvidia revendique jusqu’à 30 % de bande passante supplémentaire et 15 % de consommation HBM en moins par rapport à la HBM4E standard.
- Annapurna Labs, filiale d’Amazon, est le premier partenaire annoncé, tandis que Samsung étudie la possibilité de faire appel à sa propre fonderie comme solution de secours pour la production.