111 contributions privées révèlent les limites des ambitions de Taïwan en matière d’IA
Le corpus d’entraînement à l’IA du gouvernement taïwanais compte 7 161 entrées, mais seules 111 proviennent de contributeurs privés. Cela représente environ 1,6 % du total, une faible proportion pour un projet destiné à aider l’intelligence artificielle à comprendre la langue, la culture et la vie quotidienne de Taïwan.
Sommaire
- 111 contributions privées révèlent les limites des ambitions de Taïwan en matière d’IA
- Contenu du corpus gouvernemental
- L’importance de la langue locale
- Une plainte pénale a changé la donne
- La place du droit d’auteur dans l’entraînement de l’IA
- Une autorisation volontaire, sans transfert de propriété
- Un précédent limité de coopération rémunérée
- Des exceptions juridiques et des licences collectives en concurrence
- TAIDE montre l’importance de l’accès aux contenus et des moyens
- À retenir
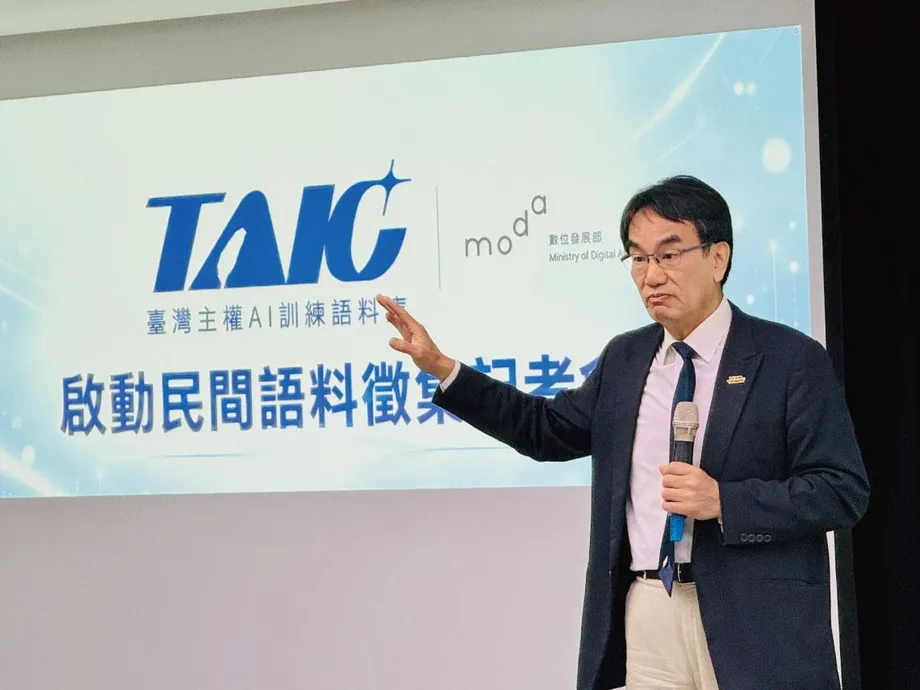
Le ministère des Affaires numériques a lancé le Corpus taïwanais souverain d’entraînement de l’IA le 24 décembre 2025. Plus de 200 organismes publics y ont contribué, avec plus de 2 000 jeux de données contenant 600 millions de jetons. Les jetons sont les petites unités de texte traitées par les systèmes d’IA : parfois un caractère, parfois une partie de mot.
La participation des administrations a permis de donner de l’ampleur au projet. Faire participer des éditeurs, des auteurs, des plateformes pédagogiques et des médias pose un problème plus complexe : les développeurs ont besoin d’une autorisation pour copier des écrits de valeur afin d’entraîner leurs modèles, tandis que les détenteurs de contenus veulent être rémunérés et garder le contrôle sur l’utilisation de leurs œuvres.
Lors d’une audition parlementaire le 14 octobre 2026, le ministre des Affaires numériques, Lin Yi-jing, a déclaré que la participation du secteur privé était volontaire et que le gouvernement souhaitait que les grandes entreprises d’IA, en particulier américaines, paient pour les contenus utilisés à l’entraînement. Les contenus d’actualité ne font pas partie du programme actuel de collecte privée.
Les enjeux concrets dépassent la taille d’une base de données. Un modèle entraîné sur des textes taïwanais peut apprendre le vocabulaire local, expliquer les traditions culturelles et répondre aux questions en tenant compte des institutions de Taïwan. Mais les auteurs et les organisations qui produisent ces contenus dépendent aussi de leur valeur commerciale. Taïwan cherche à élargir l’accès à leurs œuvres tout en déterminant qui doit payer, ce que couvre l’autorisation et quels aspects du droit d’auteur doivent être clarifiés.
Contenu du corpus gouvernemental
L’annonce du lancement en décembre du ministère décrit un corpus couvrant la langue, la culture, l’éducation, la biologie et la géographie. Il s’appuie sur plus de dix ans de données publiques gouvernementales et permet de rechercher et de télécharger des documents.
Le ministère de la Culture a fourni des jeux de données sur l’art public et le patrimoine culturel. Le ministère de l’Éducation a contribué avec des données de dictionnaires couvrant le taïwanais, le hakka et le mandarin. Ces ressources fournissent aux développeurs des informations sur les significations et les usages locaux, ainsi que sur les lieux, les objets et les traditions.
La présentation du programme de corpus du ministère cite également le Conseil des peuples autochtones et le Conseil des affaires hakka parmi les organismes participants. Les thèmes prévus comprennent l’histoire, le patrimoine culturel, le tourisme et la culture locale. Selon le ministère, les textes d’entraînement utiles doivent être cohérents, complets et fluides.
Les chiffres présentés aux parlementaires en septembre 2026 faisaient état de plus de 5 000 jeux de données et de plus de 2,4 milliards de jetons. Par rapport aux 600 millions de jetons annoncés au lancement, le volume de texte mesuré en jetons a ainsi été multiplié par plus de quatre. Les 7 161 entrées et les 111 contributions privées donnent un autre aperçu de la composition du corpus.
L’importance de la langue locale
Wu Che-yu, artiste en nouveaux médias et fondateur du projet de connaissances communautaires Taiwan.md, estime que les textes en chinois traditionnel occupent une place trop réduite dans les données d’entraînement des principales IA. Il évalue à moins de 1 % leur part des contenus d’entraînement en chinois, estimation qu’il cite pour expliquer son projet.
Les préoccupations de Wu ne se limitent pas à la conversion des caractères simplifiés en caractères traditionnels. Taïwan et la Chine emploient des mots différents pour certaines choses du quotidien, et une même expression peut avoir des sens différents. Les connaissances locales englobent aussi les institutions, l’histoire et la cuisine, notamment des plats moins connus à l’international que le thé aux perles ou les raviolis en soupe.
Taiwan.md utilise des outils d’IA pour recueillir des informations sur le Web et rédiger des articles sur la nature, la société et l’histoire de Taïwan. Ses 1 123 articles s’appuient sur des publications universitaires, des blogs et des informations gouvernementales accessibles au public. Wu souhaite que les principaux modèles, comme ChatGPT, Gemini et Claude, rencontrent davantage de textes reflétant l’expérience taïwanaise.
Le gouvernement présente cette ambition connexe comme une démarche d’IA souveraine : développer des ressources et des capacités d’IA que Taïwan peut façonner selon ses propres besoins. Son corpus fournit des données d’entraînement ; des projets comme Taiwan.md cherchent à rendre les connaissances locales plus accessibles aux développeurs d’IA.
Une plainte pénale a changé la donne
En juillet 2025, un doctorant de l’Université nationale de Taïwan a fait l’objet d’une plainte pénale pour violation du droit d’auteur après avoir diffusé un corpus en chinois traditionnel contenant 140 000 articles non autorisés de l’Agence centrale de presse. L’étudiant avait recueilli ces documents sur un site américain hébergeant des ressources ouvertes et partagé le corpus gratuitement.
Les parties ont ensuite conclu un accord. L’étudiant a présenté ses excuses, appelé les chercheurs à vérifier la légalité de leurs sources de données et supprimé l’intégralité du corpus.
Wu affirme que cette affaire a rendu les développeurs indépendants plus prudents. L’équipe de Taiwan.md écarte les contenus dès qu’elle soupçonne un problème de droit d’auteur, ce qui ralentit l’expansion de son corpus. Pour un petit projet, la possibilité de poursuites pénales ajoute un risque personnel à une tâche déjà complexe de vérification des autorisations.
Plusieurs dates permettent de comprendre l’évolution du dossier :
- Début 2023 : le Conseil national des sciences et technologies lance le projet de modèle linguistique TAIDE, doté de plus de 200 millions de dollars taïwanais.
- Juillet 2025 : le doctorant fait l’objet d’une plainte concernant le corpus contenant des articles d’actualité non autorisés.
- 24 décembre 2025 : le ministère des Affaires numériques annonce son corpus souverain d’IA, qui compte 600 millions de jetons.
- Septembre 2026 : les chiffres du ministère font état de plus de 5 000 jeux de données et de plus de 2,4 milliards de jetons.
- 14 octobre 2026 : le ministre Lin déclare aux parlementaires que les contributions privées sont volontaires et que la conclusion d’accords rémunérés est un objectif politique.
La place du droit d’auteur dans l’entraînement de l’IA
Chen Chi-tung, avocat principal au cabinet Luguo Law Firm, considère la copie comme une question juridique centrale. Les développeurs doivent généralement reproduire les textes avant de les utiliser pour entraîner un modèle. Le droit d’auteur permet aux titulaires de contrôler la reproduction de leurs œuvres, sous réserve d’exceptions comme l’usage équitable.
L’usage équitable autorise, dans certaines circonstances, certains usages d’œuvres protégées sans permission. Selon Chen, les dispositions actuelles à Taïwan ne traitent pas expressément de l’entraînement de l’IA, ce qui laisse les développeurs dans l’incertitude quant à la manière dont un tribunal pourrait apprécier leurs pratiques.
L’entraînement et la production d’une réponse correspondent également à des actes différents. Lors de l’entraînement, un système traite des exemples pour apprendre des modèles. Lors de la génération, il produit un texte à destination d’un utilisateur. Chen propose que la loi traite séparément ces deux étapes, notamment le risque que les réponses ressemblent de très près à des œuvres protégées.
L’Office de la propriété intellectuelle, qui relève du ministère des Affaires économiques, indique que d’éventuelles adaptations juridiques sont à l’étude. Le ministère des Affaires numériques désigne cet office comme responsable de la politique en matière de droit d’auteur. Une enquête du Yuan de contrôle a également appelé à adapter activement le cadre juridique, après que le Yuan exécutif a confié cette tâche à l’office.
Une autorisation volontaire, sans transfert de propriété
Le ministre Lin a indiqué à la commission des Transports du Parlement que le programme de collecte auprès du secteur privé visait d’abord les éditeurs et les plateformes de livres numériques. Il a décrit quatre types de contenus recherchés :
- Des livres dont la protection par le droit d’auteur a expiré.
- Des notices de livres fournies par les éditeurs.
- Des extraits de présentation sélectionnés dans des livres.
- Des œuvres concédées sous licence volontairement par des auteurs individuels.
Lin a déclaré que le ministère demandait l’autorisation d’utiliser les œuvres pour entraîner l’IA, les auteurs en conservant la propriété intellectuelle. Une licence permet à un tiers d’effectuer certaines activités dans des conditions convenues. Elle peut notamment préciser les utilisations autorisées et la durée de l’autorisation.
Lin Chu-yin, députée du Parti démocrate progressiste, a demandé comment les contributeurs seraient rémunérés, ce qui se passerait s’ils retiraient ensuite leur autorisation et comment leurs intérêts seraient protégés si l’entraînement débouchait sur d’autres produits. Hung Yu-hsiang, député du Parti populaire taïwanais, a proposé un service chargé du contrôle de la qualité, de la vérification des droits, de l’acquisition rémunérée et de la gestion des différentes catégories de licences.
Le ministère a publié la licence du Corpus taïwanais souverain d’entraînement de l’IA, version 1, et travaillé avec l’Office de la propriété intellectuelle à des exemples destinés à aider les organismes publics à l’appliquer. Des conditions standardisées visent à réduire les négociations répétées et les litiges liés au droit d’auteur. Le ministère prévoit aussi des incitations à contribuer. Les taux de rémunération, les modalités de retrait et les règles concernant les produits dérivés n’ont pas été fixés dans les propositions rendues publiques.
Un précédent limité de coopération rémunérée
Lee Po-feng, président de l’Open Culture Foundation, estime qu’il est peu probable que demander aux éditeurs de fournir gratuitement des contenus de valeur suscite une participation suffisante. Il cite un petit projet d’entraînement qui a obtenu la coopération de médias et de plateformes éducatives grâce à un accord négocié.
Les conditions prévoyaient un paiement unique pour la licence, une durée d’utilisation des données limitée à deux ans et un accès prioritaire au modèle obtenu pour les fournisseurs de contenus participants. L’accord a apporté aux contributeurs une rémunération, une durée d’utilisation définie et un avantage concret en retour.
Wang Rong-wen, président des éditions Yuan-Liou, estime lui aussi que les développeurs publics et commerciaux devraient prévoir un budget pour les licences de contenu. Il considère que la crainte de plaintes pénales freine à la fois les développeurs privés et les responsables qui tentent de soutenir les projets d’IA.
Lin a déclaré aux parlementaires que l’objectif final du gouvernement était de faire payer l’accès aux grandes entreprises d’IA. Il a ajouté que les litiges sur le droit d’auteur liés aux nouvelles technologies pouvaient durer de trois à cinq ans et que le ministère commençait donc par les contenus les moins litigieux. Son calendrier évoquait la durée probable des controverses, et non une échéance pour une loi ou un dispositif de rémunération.
Des exceptions juridiques et des licences collectives en concurrence
Chen propose d’ajouter un chapitre consacré à l’IA dans la loi taïwanaise sur le droit d’auteur. Celui-ci établirait une exception pour l’exploration de textes et de données, imposerait la divulgation des sources d’entraînement et réduirait le risque de poursuites pénales pour les activités répondant aux critères.
L’exploration de textes et de données consiste à utiliser des logiciels pour analyser de grandes quantités de contenus et repérer des tendances. L’Union européenne, le Japon et Singapour prévoient des exceptions pour certaines formes de cette activité, même si leurs règles et leurs conditions diffèrent. Chen voit dans ces approches des pistes pour le débat à Taïwan.
Lee propose une première mesure administrative : publier des orientations expliquant quels usages d’entraînement les autorités considèrent comme relevant de l’usage équitable et lesquels présentent un risque de contrefaçon. Il cite l’Agence japonaise des affaires culturelles et sa liste de contrôle et ses recommandations de 2024 sur le droit d’auteur et l’IA, qui illustrent la façon de rendre les attentes plus concrètes pour les développeurs et les créateurs.
Chen suggère également un système de licences collectives, à l’image de la Société taïwanaise de gestion des droits d’auteur musicaux, connue sous le nom de MÜST. Dans ce modèle, un organisme gère les autorisations de nombreux titulaires de droits, perçoit les redevances et en répartit le produit. Pour l’IA, un service similaire pourrait éviter de négocier séparément avec des centaines d’éditeurs ou d’auteurs.
Chang Chung-hsin, professeur assistant associé à l’Institut de la propriété intellectuelle de l’Université nationale de technologie de Taipei, défend une autre approche. Selon lui, les développeurs devraient payer en vertu des règles actuelles sur le droit d’auteur plutôt que de réclamer une modification de la loi. Sa position place la négociation d’un accès aux contenus éditoriaux et d’actualité de valeur au cœur de la solution.
TAIDE montre l’importance de l’accès aux contenus et des moyens
Le précédent modèle taïwanais Trustworthy AI Dialogue Engine, ou TAIDE, illustre à quel point un modèle peut dépendre de quelques corpus accessibles. Lancé début 2023 dans le cadre d’un projet du Conseil national des sciences et technologies, son développement initial a bénéficié de plus de 200 millions de dollars taïwanais.
TAIDE a utilisé des données d’entraînement provenant de 15 organismes publics. Environ quatre millions d’articles de l’Agence centrale de presse représentaient 70 % de ses données textuelles. Les contenus avaient été obtenus en tenant compte des questions de droit d’auteur, ce qui montre qu’un accès organisé à de vastes archives d’actualité peut soutenir un modèle local.
Le chercheur principal Yuh-Jye Lee, du Centre taïwanais de sécurité de l’information de l’Academia Sinica, a expliqué l’intérêt de disposer d’une solution nationale :
Au début, nous ne pourrons probablement pas rivaliser avec les grands modèles, mais disposer de notre propre moteur de dialogue nous donne au moins le choix.
Le premier modèle reposait sur Llama 2 de Meta et comptait sept milliards de paramètres, c’est-à-dire les valeurs numériques qu’un modèle ajuste pendant son apprentissage. Le Centre national de calcul haute performance disposait de 1 028 processeurs graphiques V100 et en a acheté neuf de type H100 en novembre 2023 pour le projet, tout en maintenant ses services habituels.
Le projet Demeter GPT de l’Université nationale Chung Hsing, qui répond aux questions sur l’agriculture, est ensuite passé de ChatGPT à TAIDE. Le professeur associé Fan Yao-chung a décrit une meilleure précision en chinois après un entraînement complémentaire. Le laboratoire payait auparavant entre 1 et 2 dollars taïwanais par réponse à OpenAI ; en faisant fonctionner TAIDE localement, il a transféré ses dépenses de fonctionnement à ses propres ordinateurs et à l’électricité.
L’initiative de corpus de Taïwan vise à fournir les textes nécessaires à ce type d’applications. Les dictionnaires et les archives culturelles du gouvernement en constituent la base. Un accès plus large aux publications, aux ressources pédagogiques spécialisées et au journalisme dépendra d’accords abordables pour les développeurs et acceptables pour les détenteurs de contenus.
À retenir
- Les contributeurs privés ont fourni 111 des 7 161 entrées du corpus, soit environ 1,6 %.
- Le gouvernement a annoncé 600 millions de jetons au lancement, en décembre 2025 ; en septembre 2026, le total dépassait 2,4 milliards.
- Le ministre Lin indique que la participation privée est volontaire et que les auteurs conservent leurs droits d’auteur.
- Les contenus d’actualité sont exclus du programme actuel de collecte privée, tandis que le ministère cherche à conclure des accords rémunérés avec les entreprises d’IA.
- Une plainte pénale déposée en juillet 2025 au sujet de 140 000 articles d’actualité non autorisés a renforcé les inquiétudes des développeurs indépendants.
- Parmi les propositions figurent des orientations plus claires sur l’usage équitable, une exception pour l’exploration de données, des licences collectives et une rémunération directe en vertu de la loi actuelle.