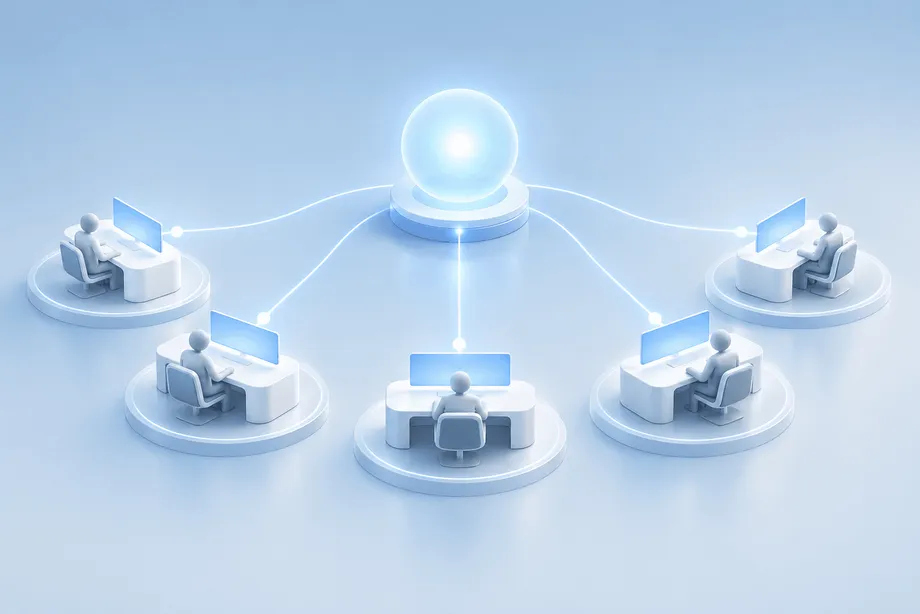
Un agent de programmation conçu pour gérer plusieurs tâches à la fois
Le 31 octobre 2026, l'équipe Harness de DeepSeek a publié la conception de son Super-agent, ainsi qu'un prototype de recherche sous licence MIT qui transforme les demandes concernant un dépôt GitHub en sessions de programmation distinctes. L'objectif est de faire avancer plusieurs tâches simultanément, tout en réduisant le temps que les développeurs consacrent à passer d'une conversation à l'autre et à vérifier l'avancement.
Sommaire
- Un agent de programmation conçu pour gérer plusieurs tâches à la fois
- Pourquoi DeepSeek veut rendre la gestion des sessions invisible
- Un Router coordonne, plusieurs Workers exécutent
- Comment les messages deviennent des tâches sans interruptions constantes
- Agir tôt, mais ne prendre la parole qu'à bon escient
- Conserver le contexte passé et les nouvelles consignes à portée de main
- Coordination dans le cloud, travail sur un ordinateur local
- Ce que l'expérience a mesuré
- Une coordination plus rapide consomme davantage de jetons mis en cache
- Les autorisations locales placent la sécurité au cœur des préoccupations
- Points clés
Lors de son expérience préliminaire, l'équipe a utilisé environ 300 messages simulés contenant une vingtaine de demandes de travail. Super-agent a terminé la moitié des tâches en 12,4 minutes et 95 % d'entre elles en 15,7 minutes. Un système de comparaison utilisant une session principale pouvant faire appel à un agent auxiliaire a mis 29,5 minutes à atteindre le seuil de 95 % avec des consignes neutres.
Le dépôt public du prototype de DeepSeek, nommé dsh-superagent-prototype, présente une version pratique au périmètre plus restreint : un agent de programmation proactif pour un seul dépôt GitHub, fourni sous forme de bundle pour DeepSeek Harness. Il surveille GitHub et, en option, Feishu, ouvre une tâche lorsqu'une personne autorisée en fait la demande et répond dans la conversation d'origine, éventuellement en proposant des modifications de code dans une pull request.
Le fichier README contient aussi un avertissement sans équivoque. Le code publié diffère du système interne et de certains éléments de l'essai de conception. Plusieurs fonctionnalités proposées restent à développer, et DeepSeek présente cette version comme du code de recherche, non comme un produit fini.
L'équipe DeepSeek Harness, qui assure la maintenance du prototype, précise son statut dans le README :
Prototype de recherche fourni à titre de référence uniquement, et non produit officiel de DeepSeek.
Pour les développeurs, cette version fournit du code à examiner et à adapter. L'expérience porte principalement sur la façon dont un agent organise le travail, garde en mémoire les conversations liées et détermine quand l'intervention d'une personne est nécessaire.
Pourquoi DeepSeek veut rendre la gestion des sessions invisible
La conception de DeepSeek part d'un constat tiré de ses propres travaux : une personne ne peut généralement suivre que trois à cinq sessions d'agents actives à la fois. Chaque session possède son propre historique de conversation ; le développeur doit donc se rappeler quelle tâche est associée à quelle session et quelles consignes chaque agent a reçues.
Un harness est le logiciel qui entoure un modèle d'IA et gère ses outils, ses fichiers, ses conversations et son exécution. Le modèle raisonne sur une tâche ; le harness détermine comment elle lui est transmise et comment ses actions sont exécutées. Super-agent confie davantage la coordination de plusieurs tâches à ce logiciel d'accompagnement.
L'équipe définit quatre objectifs : assurer la continuité entre les conversations, exécuter efficacement les tâches en parallèle, répondre de façon proactive aux événements et fonctionner de manière persistante tout en récupérant après les défaillances. Dans un exemple, les développeurs choisissent un plan dans une discussion, puis le modifient plus tard dans un commentaire GitHub. Le système doit relier ces échanges et adapter la même tâche.
Cette version fait suite à l'expérience menée par DeepSeek le 3 octobre sur la compatibilité des extensions de Claude Code dans Harness v0.2.1-alpha.1. Cette mise à jour testait une passerelle pour les extensions ; Super-agent explore la façon dont le harness lui-même peut coordonner le travail en cours. Yujia Qiao est crédité de la mise en œuvre du système et de la rédaction de l'essai de conception ; 15 autres personnes sont mentionnées comme ayant participé aux évaluations et aux discussions.
Un Router coordonne, plusieurs Workers exécutent
Super-agent répartit les responsabilités entre un Router toujours actif et des Workers distincts. Le Router reçoit les échanges avec les utilisateurs, gère les informations communes aux différentes tâches et attribue le travail. Il ne code pas lui-même, afin de rester disponible pour la coordination pendant que les autres sessions sont occupées.
Les Workers s'occupent des tâches individuelles. Chacun dispose de son propre contexte de conversation et de ses outils d'exécution, ce qui permet de mener en parallèle l'analyse d'un bogue, une réponse à une revue de code et une modification de fonctionnalité. Les Workers transmettent leurs résultats au Router, qui communique avec les utilisateurs au lieu de laisser plusieurs sessions répondre séparément.
DeepSeek estime qu'un modèle plus léger peut souvent prendre en charge le routage, tandis que des modèles plus puissants réalisent les tâches qui déterminent la qualité du code. Un Worker peut aussi créer des agents auxiliaires pour une mission complexe. Le Router gère les relations entre les tâches plutôt que de planifier chacune de leurs étapes.
Le prototype attribue à chaque tâche sa propre session et son propre répertoire, et les lance en parallèle jusqu'à la limite configurée. Les opérateurs déterminent ainsi le volume de travail démarré simultanément. Des historiques de conversation séparés réduisent le risque que les détails d'une tâche prennent le pas sur ceux d'une autre, tandis que le Router conserve une vue d'ensemble commune.
Comment les messages deviennent des tâches sans interruptions constantes
Les messages de discussion, les commentaires de revue de code et les résultats des tests automatisés deviennent des événements susceptibles de déclencher une action. La conception générale prend aussi en compte les courriels et les rappels de calendrier. L'intégration continue, ou CI, désigne les vérifications automatisées qui compilent ou testent le code après une modification et produisent des résultats auxquels un agent peut réagir.
DeepSeek filtre ces événements en deux étapes. Des règles de programme classiques vérifient d'abord des éléments comme la source, le groupe et les utilisateurs autorisés. Un modèle évalue ensuite les événements restants en tenant compte du contexte et des règles écrites. Cette méthode évite de solliciter le modèle pour les messages courants qui ne nécessitent aucune action.
Les événements liés sont regroupés dans un Thread, par exemple les commentaires sous une même pull request ou ceux d'un même sujet de discussion. Dès qu'un Worker prend en charge la tâche, il s'abonne à ce Thread. Les commentaires et résultats de tests ultérieurs peuvent alors lui être transmis directement, sans demander au Router de les attribuer à nouveau.
Plusieurs abonnements peuvent se chevaucher. Les Workers qui interviennent sur la même pull request peuvent recevoir les mêmes mises à jour et ainsi repérer les changements susceptibles d'influer sur leur travail. Un Worker peut aussi suivre plusieurs Threads liés, ou renvoyer un événement au Router s'il sort du cadre de sa mission.
Agir tôt, mais ne prendre la parole qu'à bon escient
DeepSeek indique qu'un Super-agent interne fonctionne déjà en continu : il reproduit et corrige des problèmes, répond aux revues de code et contribue au développement de Harness lui-même. Une règle écrite l'autorise à enquêter sur les bogues signalés dans une discussion de groupe, même si personne ne mentionne directement l'agent.
Cette règle privilégie d'abord une enquête discrète. L'agent tente de reproduire le problème signalé et de trouver une solution simple, puis présente un résultat utile. Dans un exemple, alors que des développeurs discutaient d'un problème d'affichage où des tildes apparaissaient comme du texte barré, l'agent avait déjà ouvert une pull request proposant un correctif.
L'équipe Harness résume le principe de fonctionnement dans son README :
Solliciter le moins possible l'attention humaine et apporter le plus de valeur possible.
Le prototype agit lorsqu'une personne autorisée le sollicite ou qu'une règle définie par l'équipe l'y autorise. Son panneau Web répertorie les tâches qui nécessitent l'attention d'un humain. L'interface se concentre ainsi sur les décisions et les résultats exploitables plutôt que sur chaque appel d'outil ou chaque réflexion intermédiaire.
Conserver le contexte passé et les nouvelles consignes à portée de main
Dans sa conception, DeepSeek assimile la fenêtre de contexte d'un modèle, c'est-à-dire la quantité limitée d'informations qu'il peut traiter à un instant donné, à un cache. Les éléments fréquemment nécessaires restent à portée de main ; l'historique plus long ou moins pertinent demeure hors de la fenêtre jusqu'à ce qu'on le demande.
L'essai appelle ces opérations Inline et Spill. Inline insère directement dans le contexte actuel des détails utiles, comme des messages récents d'une discussion, des identifiants ou un bref aperçu. Spill conserve les contenus plus longs ailleurs et fournit une référence que le modèle peut suivre pour les consulter.
Chain of Recall relie ces références. Les événements, les Threads et les sessions des Workers reçoivent des identifiants uniques. L'agent peut ainsi passer d'un message actuel à la discussion correspondante, puis à un Worker lié et à une autre revue de code. Le but est de retrouver une ancienne tâche sur plusieurs canaux sans recharger systématiquement l'intégralité de son historique.
DeepSeek s'attaque aussi à un problème d'interruption plus immédiat : une commande longue peut empêcher un agent classique de répondre. Son mécanisme asynchrone lance le travail en arrière-plan et en renvoie le résultat sous la forme d'un nouvel événement. Les utilisateurs peuvent continuer à donner des consignes, notamment demander à l'agent de changer de direction ou de s'arrêter.
L'équipe précise que ce mécanisme est implémenté dans DeepSeek Harness, mais qu'il n'est pas activé par défaut. Les règles de communication varient aussi selon le canal : la conception limite à 100 mots une réponse instantanée unique dans une messagerie, tandis que les pull requests et les documents comportent des explications plus structurées sur les modifications et les vérifications.
Coordination dans le cloud, travail sur un ordinateur local
DeepSeek dissocie le calcul qui fait fonctionner l'agent, l'historique des sessions stocké et la machine sur laquelle les commandes sont exécutées. La boucle de l'agent proposée s'exécute dans des conteneurs cloud, l'état des sessions est conservé dans une base de données et un service local léger exécute les commandes puis renvoie les résultats.
Cette organisation permet d'utiliser son propre ordinateur, ou BYOM (« Bring Your Own Machine »). Un développeur peut connecter un ordinateur existant contenant le dépôt, les outils et les modifications en cours, sans tout déplacer vers un nouvel environnement distant. La coordination dans le cloud peut rester disponible lorsque cet ordinateur est déconnecté ; les tâches qui en dépendent attendent alors son retour en ligne.
Une session Watchdog indépendante surveille les défaillances et les tâches bloquées. Elle ne se contente pas de repérer un message d'erreur : elle évalue, à l'aide du modèle, si les Workers progressent réellement ou s'éloignent de l'objectif, puis tente de rétablir la situation au besoin.
DeepSeek présente ces éléments comme des composantes d'une exploration plus vaste de son architecture. Le README avertit que le bundle public diffère de l'implémentation interne ; les développeurs doivent donc examiner le code publié avant de compter sur une fonctionnalité précise de la conception.
Ce que l'expérience a mesuré
DeepSeek a répété cinq fois chaque configuration expérimentale, en comparant Super-agent à une version sans transmission directe des événements et à deux configurations reposant sur une session unique dotée d'un agent auxiliaire. La charge de travail utilisait des messages synthétiques et un outil simulant de longues tâches de programmation. Les intervalles entre les messages et la durée du travail ont été ramenés au quart.
La médiane de 12,4 minutes signifie que la moitié des tâches étaient terminées à ce moment-là. Le 95e percentile de 15,7 minutes indique que 95 % des tâches ont été terminées dans ce délai. Par rapport au 95e percentile de 29,5 minutes de la session unique avec des consignes neutres, Super-agent a réduit cette mesure de 13,8 minutes, soit environ 47 %.
Le comportement en matière de délégation aide à comprendre ce résultat. Avec des consignes neutres, la session unique n'a jamais fait appel à son agent auxiliaire lors des cinq essais. Lorsqu'on lui a demandé de privilégier la délégation, elle a délégué dans quatre essais et effectué elle-même le travail dans le cinquième. Super-agent fait de la séparation entre coordination et exécution un choix structurel.
Les tests ont évalué la planification et la coordination à partir d'une exécution simulée. La qualité réelle du code, les performances mesurées par des évaluateurs indépendants et le nombre d'utilisateurs actifs ne sont pas communiqués, tandis que l'équipe qualifie ses mesures de préliminaires. DeepSeek n'a annoncé aucune date de sortie commerciale.
Une coordination plus rapide consomme davantage de jetons mis en cache
La mise en parallèle de Super-agent s'est accompagnée d'une utilisation accrue des jetons d'entrée mis en cache. Il en a lu 23,23 millions, contre 6,05 millions et 10,82 millions pour les deux configurations à session unique. Les jetons sont les petites unités de texte traitées par un modèle ; la lecture du cache réutilise des données d'entrée conservées à la suite de requêtes antérieures.
La suppression de la transmission directe des événements a fait passer le nombre de jetons lus dans le cache de 23,23 à 31,77 millions, soit une hausse d'environ 37 %, et augmenté d'environ 30 % le nombre de décisions du Router. Transmettre les événements de suivi directement au Worker chargé de la tâche a donc réduit le travail de coordination au sein du système parallèle.
Le regroupement des événements a aidé le Router à gérer une charge plus importante. Lorsque leur fréquence de réception est passée d'environ un à 40 déclencheurs par minute, la taille moyenne des lots a augmenté de 1,0 à 2,8 et la durée des requêtes de 2,5 à 3,9 secondes. Le temps d'inférence indiqué pour chaque décision du Router a diminué de 6,4 à 1,6 seconde.
Le compromis pratique consiste à réduire le temps d'attente des utilisateurs au prix d'un traitement accru par les modèles répartis sur plusieurs sessions. Les chiffres de consommation de jetons ne constituent pas une facture en euros ; les équipes envisageant un déploiement doivent tenir compte des tarifs des modèles, des paramètres de concurrence et de leur charge de travail réelle.
Les autorisations locales placent la sécurité au cœur des préoccupations
La documentation du prototype indique que les commandes des Workers s'exécutent sans approbation avec le compte du système d'exploitation de l'opérateur. Au premier plan, les commandes shell passent en arrière-plan au bout de cinq secondes, et les tâches en arrière-plan disposent de 30 minutes au maximum par tour. Ces paramètres font des autorisations du compte de l'opérateur un enjeu concret pour le déploiement.
Un ordinateur connecté peut contenir des identifiants, du code privé et des fichiers sensibles. L'injection de prompt, une technique par laquelle un contenu malveillant tente de détourner un agent au moyen des éléments qu'il consulte, devient particulièrement préoccupante lorsque des messages entrants ou le contenu d'un dépôt peuvent influer sur les commandes exécutées sur cette machine.
DeepSeek cite la sécurité et la confidentialité, la capacité du Router à monter en charge, la mémoire à long terme et la communication entre instances d'agents parmi les aspects qui restent à développer. Le README invite les utilisateurs à examiner et à adapter le code, en précisant que des bogues et des pratiques d'ingénierie incohérentes peuvent subsister. Une grande partie du travail d'ingénierie a elle-même été réalisée par des agents de programmation.
Le lancement a rapidement suscité de l'intérêt, notamment avec une publication de Leandro von Werra, responsable de la recherche chez Hugging Face. La chronologie montre à quelle vitesse le prototype s'est diffusé :
- 31 octobre 2026, à 09:32 UTC : création du dépôt GitHub.
- 31 octobre : l'équipe Harness publie son essai de conception ; à 22:10 UTC, le dépôt compte 2 046 étoiles et 172 forks.
- 1er novembre, à 04:20 UTC : le dépôt atteint 3 433 étoiles.
Pour les équipes d'ingénierie, la décision immédiate consiste à déterminer s'il convient d'examiner et d'adapter un système expérimental de coordination. Son attrait tient à la possibilité de gérer davantage de tâches avec moins d'interruptions ; son exploitation exige notamment de vérifier le code, de définir les autorisations et de décider quelles actions nécessitent l'intervention d'une personne.
Points clés
- DeepSeek a publié un prototype de recherche sous licence MIT pour effectuer des tâches de programmation dans un dépôt GitHub, avec une intégration facultative à Feishu.
- Un Router assure la coordination tandis que des Workers distincts exécutent les tâches en parallèle.
- Le système interne peut enquêter sur les bogues signalés, selon des règles écrites, sans être directement mentionné.
- Les tests synthétiques ont enregistré un délai médian d'exécution de 12,4 minutes et un 95e percentile de 15,7 minutes, avec une consommation de jetons mis en cache supérieure à celle des solutions à session unique.
- Les Workers exécutent des commandes sans approbation avec le compte de l'opérateur, ce qui place les autorisations et les identifiants au cœur des préoccupations.
- Le code public diffère du système interne et reste un prototype de recherche, non un produit officiel de DeepSeek.