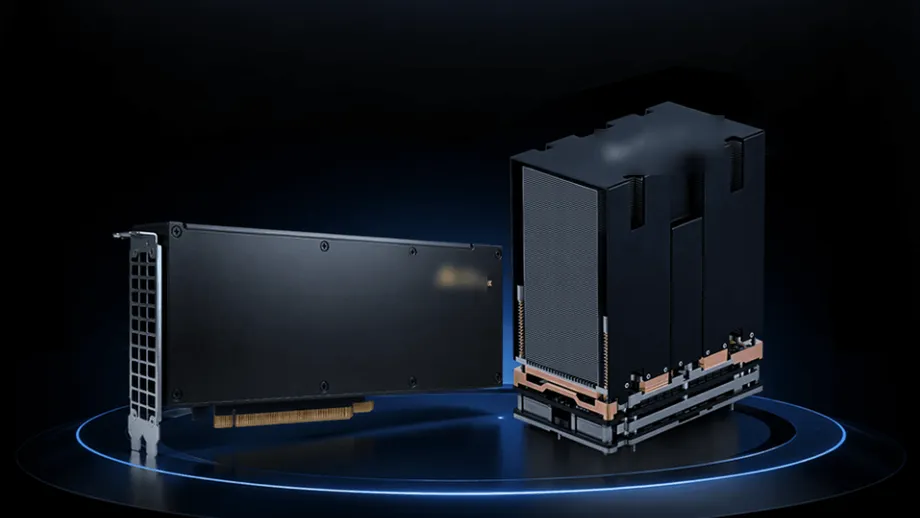
Un GPU opérationnel et une performance revendiquée supérieure de 5 %
Iluvatar CoreX a présenté publiquement son processeur graphique Tiangai 300 à Shanghai, le présentant comme une alternative chinoise à la Nvidia H200 et revendiquant un avantage de 5 % lors d’un test d’inférence réalisé par un tiers. Lors de sa journée portes ouvertes aux médias, le 28 octobre 2026, l’entreprise a également montré un système d’entraînement doté de huit GPU et décrit une baie comprenant 144 GPU et 18 CPU.
Sommaire
- Un GPU opérationnel et une performance revendiquée supérieure de 5 %
- Ce que mesure la comparaison avec la H200
- Documents longs et premières réponses plus rapides
- Les résultats d’entraînement reposent sur une autre référence Nvidia
- Du lancement de juillet à la démonstration d’octobre
- Une baie conçue autour de 144 GPU
- Répartir le travail d’IA entre différentes puces
- Les logiciels visent à réduire les délais de déploiement
- La TY1200 élargit l’offre aux robots
- Points clés
La comparaison mise en avant repose sur des tests réalisés en juillet par Shanghai Electric Group, selon Iluvatar CoreX. Dans un déploiement séparant les deux étapes du traitement des grands modèles de langage, la Tiangai 300 a atteint un débit de bout en bout équivalent à 1,05 fois celui d’une H200, après conversion des résultats en une valeur par carte.
Le débit désigne la quantité de travail utile qu’un système accomplit dans un temps donné. Pour un chatbot, il peut s’agir du nombre de segments de texte générés chaque seconde. Un résultat équivalent à 1,05 fois les performances de référence signifie que la production a été supérieure de 5 % dans les conditions de ce test.
L’entreprise a présenté la Tiangai 300 comme le premier GPU généraliste chinois à atteindre les performances de la H200 lors de tests mesurés. Sa démonstration d’octobre a étendu la comparaison aux modèles de langage, à la génération d’images et à celle de vidéos, tandis qu’une démonstration distincte d’entraînement prenait la Nvidia H100 pour référence.
L’événement ne s’est pas limité aux caractéristiques d’une puce. Iluvatar CoreX a présenté des cartes, des serveurs, une conception de baie haute densité, des outils logiciels ainsi qu’une méthode de répartition du travail d’IA entre différents types de processeurs. Son argument commercial est que ces éléments peuvent produire des résultats utiles en IA à moindre coût et avec moins d’attente.
Ce que mesure la comparaison avec la H200
Le test réalisé en juillet par Shanghai Electric Group utilisait la séparation entre préremplissage et décodage, souvent abrégée en PD. Le préremplissage est l’étape pendant laquelle un modèle de langage lit la demande de l’utilisateur et les documents associés. Le décodage est l’étape où il génère une réponse, un jeton à la fois. Les jetons sont les petites unités en lesquelles les systèmes d’IA découpent le texte.
Séparer ces étapes permet d’affecter différemment les ressources à la lecture et à la rédaction. Le résultat de la Tiangai 300 concerne donc une configuration de déploiement particulière, dont les performances totales sont exprimées sous la forme d’une valeur équivalente par carte.
Iluvatar CoreX n’a pas publié le protocole détaillé, la liste des modèles ni les conditions de charge associés au résultat mis en avant dans ce test réalisé par un tiers. Ces informations, ainsi que le calcul de conversion et les paramètres logiciels, sont nécessaires pour permettre une reproduction indépendante. La comparaison des coûts ne s’accompagne pas non plus d’une ventilation publiée, et les chiffres relatifs à la mémoire des cartes individuelles et de la baie complète doivent être clarifiés.
Les démonstrations citées du laboratoire de performance donnent une image plus détaillée des revendications de l’entreprise. Elles font état d’améliorations différentes selon les tâches, d’un léger gain en génération multimodale à une hausse plus importante du débit des systèmes de recommandation. Pour un acheteur, la comparaison pertinente porte sur les tâches réellement exécutées par son propre service.
Documents longs et premières réponses plus rapides
Selon le laboratoire de l’entreprise, les performances de la Tiangai 300 en matière d’attention ont atteint 1,05 fois celles de la H200 avec un contexte de 64K. L’attention est le mécanisme qui aide un modèle à déterminer quelles parties de ses données d’entrée sont liées. Un contexte de 64K signifie que le modèle traite environ 64 000 jetons.
Sur GLM-5.3, à la même échelle de contexte, Iluvatar CoreX a revendiqué un débit équivalent à 1,15 fois celui de la H200, tout en maintenant une expérience utilisateur équivalente. Cela représente une hausse de 15 % pour la charge de travail à mélange d’experts testée. Un modèle à mélange d’experts oriente le travail vers des réseaux spécialisés sélectionnés, au lieu d’utiliser tous les réseaux pour chaque jeton.
Pour les charges de travail d’agents d’IA avec des contextes allant de 8K à 128K, l’entreprise a annoncé une réduction d’environ 10 % à 30 % du délai avant la production du premier jeton. Cette mesure compte pour une personne qui attend qu’un assistant commence à répondre après avoir lu un long document ou traité une demande complexe.
La génération d’images et de vidéos faisait également partie de la démonstration. L’entreprise a annoncé une hausse d’environ 2 % à 5 % du débit de génération multimodale par rapport à la H200. Pour les charges de travail de recherche en ligne, de publicité et de recommandation, elle a revendiqué un débit d’inférence des recommandations supérieur de 21 % et une latence réduite de 26 % pour les calculs légers.
Les résultats d’entraînement reposent sur une autre référence Nvidia
La démonstration d’entraînement portait sur Qwen3-32B, un modèle d’environ 32 milliards de paramètres, exécuté sur un serveur équipé de huit GPU. Les paramètres sont les valeurs numériques qu’un modèle ajuste pendant l’entraînement pour apprendre des schémas. Iluvatar CoreX a indiqué que le débit effectif par carte avait atteint 1,33 fois celui de la Nvidia H100.
L’avantage annoncé était donc de 33 % pour cette démonstration d’entraînement, la H100 étant la puce de comparaison. Les résultats d’inférence présentés ailleurs lors de l’événement prenaient la H200 pour référence. Il est essentiel de distinguer ces deux produits de référence pour comprendre les chiffres.
Le système d’entraînement fonctionnait en précision FP8. Le FP8 stocke les nombres sur huit bits, ce qui réduit la quantité de données à déplacer et à traiter par rapport aux formats utilisant davantage de bits. Les logiciels d’entraînement de l’IA doivent gérer soigneusement cette précision réduite pour préserver la qualité de l’apprentissage.
Iluvatar CoreX a également fait état d’une variation du temps d’exécution des étapes de 0,43 % lors d’un fonctionnement prolongé à pleine charge, contre 0,76 % pour un système de référence basé sur Hopper. Le temps d’exécution d’une étape correspond au temps nécessaire pour achever une unité de travail répétée. Une durée plus régulière peut aider les opérateurs à prévoir la quantité de travail qu’un système très sollicité pourra accomplir.
Du lancement de juillet à la démonstration d’octobre
La Tiangai 300 a été officiellement présentée à la Conférence mondiale sur l’intelligence artificielle en juillet 2026. Elle repose sur l’architecture Tianshu de l’entreprise, intègre une nouvelle génération de cœurs Tensor et dispose, selon ses caractéristiques annoncées, de 144 Go de mémoire graphique.
Le processeur prend en charge les opérations scalaires, vectorielles et tensorielles. En termes simples, celles-ci portent respectivement sur des nombres individuels, des groupes de nombres et des tableaux mathématiques plus vastes. Les formats numériques pris en charge comprennent FP4, FP8, FP16 et BF16, ce qui donne aux développeurs logiciels plusieurs options en matière de vitesse, d’utilisation de la mémoire et de précision numérique.
Les étapes publiques décrites par l’entreprise s’étendent sur plusieurs mois :
- Juillet 2026 : la Tiangai 300 est lancée à la Conférence mondiale sur l’intelligence artificielle.
- Juillet 2026 : Shanghai Electric Group réalise le test par un tiers cité pour la comparaison de débit avec la H200.
- Avant l’événement d’octobre destiné aux médias : la conception de la baie IXL144 est présentée au Salon international de l’industrie de Chine.
- 28 octobre 2026 : Iluvatar CoreX ouvre à la presse des démonstrations en direct de matériel Tiangai 300 à Shanghai.
L’événement d’octobre a fait passer la présentation du produit des exposés sur l’architecture à des systèmes exécutant des charges de travail identifiées. Selon l’entreprise, la gamme de déploiement s’étend désormais des cartes accélératrices individuelles aux serveurs équipés de huit cartes et au système IXL144 de plus grande capacité.
Une baie conçue autour de 144 GPU
L’IXL144 réunit 144 GPU et 18 CPU dans une baie standard, avec environ 10,1 To de mémoire GPU cumulée, selon Iluvatar CoreX. L’entreprise l’a décrite comme le supernœud GPU le plus dense du secteur installé dans une seule baie. Un supernœud relie étroitement de nombreux processeurs afin qu’ils puissent travailler ensemble sur des tâches de grande ampleur.
La capacité annoncée de 144 Go par Tiangai 300 et le total de 10,1 To annoncé pour la baie nécessitent une ventilation plus claire de la configuration. La multiplication de 144 cartes par 144 Go donne 20 736 Go, sans tenir compte des différences de méthode de calcul de la capacité. La description de la baie doit préciser la configuration des cartes et la capacité mémoire mise à la disposition des charges de travail.
Iluvatar CoreX estime que le système peut réduire d’environ 40 % le coût par million de jetons effectifs par rapport aux systèmes internationaux courants. Les jetons effectifs désignent les résultats comptabilisés comme travail utile. Pour les opérateurs qui vendent des services d’IA, cette mesure met en relation les dépenses en matériel et le volume de résultats exploitables produits.
Une baisse de 40 % signifierait un coût de 60 unités pour un travail coûtant 100 unités sur le système de référence. Les économies réelles dépendront du prix du matériel, de sa consommation électrique, des logiciels, de la charge de travail et du taux d’utilisation des GPU.
L’entreprise a également indiqué que son moteur d’interconnexion pair à pair de prochaine génération visait à ramener de 3 à 5 microsecondes à 1 microseconde la durée d’un transfert unique au sein du domaine connecté. Des communications plus rapides sont utiles lorsque différents GPU hébergent différentes parties d’un modèle et doivent échanger des données à répétition.
Répartir le travail d’IA entre différentes puces
L’approche de déploiement hétérogène d’Iluvatar CoreX confie différentes parties de l’inférence à différents types de processeurs. Avec son schéma de séparation AFD, la Tiangai 300 prend en charge toute l’étape de préremplissage ainsi que les calculs d’attention pendant le décodage. Le XPU d’un partenaire exécute les réseaux experts à propagation avant.
XPU est une désignation générale pour un autre type d’accélérateur informatique. L’idée consiste à confier à chaque processeur les tâches qu’il exécute le mieux, tandis qu’un ordonnanceur commun coordonne l’ensemble du travail. Les réseaux à propagation avant réalisent une autre partie importante des calculs mathématiques au sein d’un modèle de langage.
L’entreprise a annoncé une baisse de 60 % de la latence d’inférence pendant le décodage grâce à un ordonnancement unifié. Il s’agit d’une configuration système distincte de l’avantage de débit de 5 % revendiqué face à la H200, et d’une mesure de performance différente.
Shan Tianyi, responsable de l’IA et du calcul accéléré chez Iluvatar CoreX, a déclaré que les futurs systèmes de calcul pour l’IA dépendraient d’une organisation efficace de différentes puces, plutôt que de l’utilisation d’un seul type de processeur pour toutes les tâches. La démonstration AFD concrétise cette stratégie avec une configuration associant GPU et accélérateurs partenaires.
Les logiciels visent à réduire les délais de déploiement
Iluvatar CoreX a également présenté une pile logicielle « AI for AI », destinée à automatiser certaines étapes du déploiement et de l’optimisation. L’entreprise a indiqué que la configuration d’un environnement était passée d’une heure à dix minutes, tandis que le nombre d’opérations manuelles avait été réduit de plusieurs dizaines à une seule.
Pour une tâche d’optimisation d’un grand modèle, l’entreprise a annoncé avoir réduit le cycle de travail de sept jours à moins de deux heures, avec des performances proches du double du niveau précédent. Ces exemples concernent le travail d’ingénierie nécessaire pour faire fonctionner efficacement les modèles sur le matériel.
L’entreprise a également revendiqué une intégration poussée avec FlyDSL, un langage servant à développer des routines de calcul pour GPU. Elle a annoncé une accélération de la compilation supérieure à 90 % et décrit un flux de travail qui nécessitait auparavant dix personnes pendant une journée et qui a été réalisé par une personne en quelques heures.
La prise en charge logicielle compte, car un processeur ne se résume pas à un matériel de calcul performant. Les modèles, les bibliothèques mathématiques et les outils de déploiement doivent fonctionner ensemble. Les démonstrations logicielles illustrent l’effort d’ingénierie que les clients pourraient devoir fournir avant de transformer un nouveau GPU en service opérationnel.
La TY1200 élargit l’offre aux robots
L’événement de Shanghai a également présenté la Tongyang TY1200, un processeur distinct destiné aux PC équipés d’IA et à l’intelligence incarnée, notamment aux robots qui perçoivent le monde physique et agissent sur lui. Sa capacité de calcul dense annoncée est de 300 TOPS, soit 300 000 milliards d’opérations par seconde. Le calcul dense comptabilise les opérations sans s’appuyer sur l’omission de calculs portant sur des valeurs nulles.
Iluvatar CoreX a affirmé que la TY1200 atteignait 1,2 fois les performances de la Nvidia Thor T5000 lors de tests portant sur Qwen3.8-27B et Qwen3.6-35B-A3B. Pour les modèles Cosmos-R2-2B et Cosmos-R2-8B dans des scénarios d’IA physique, l’entreprise a annoncé des performances équivalentes respectivement à 158 % et à 180 % de celles de la Thor T5000 de référence.
L’entreprise a également indiqué que la TY1200 pouvait exécuter des simulations physiques accélérées par GPU avec MuJoCo-Warp. Un système de développement robotique peut ainsi simuler des mouvements, entraîner une stratégie de commande et vérifier des actions localement. Une stratégie de commande est l’ensemble des instructions apprises qu’un robot utilise pour décider de ses mouvements.
Parmi les applications annoncées figurent des robots assistant les patients lors de consultations médicales, la vision industrielle et l’orientation des visiteurs. Un successeur prévu, le TY2000, affiche une capacité de calcul annoncée de 600T. Ensemble, ces produits étendent la stratégie de l’entreprise des grands serveurs d’IA aux équipements utilisés à proximité des utilisateurs et des machines.
Points clés
- Iluvatar CoreX a présenté le matériel Tiangai 300 à Shanghai le 28 octobre 2026.
- L’entreprise a cité les tests de Shanghai Electric Group, qui indiquaient un débit par carte équivalent à 1,05 fois celui de la Nvidia H200.
- Une démonstration d’entraînement de Qwen3-32B sur huit GPU aurait atteint un débit par carte équivalent à 1,33 fois celui de la H100, en précision FP8.
- La méthode détaillée du test de référence par un tiers mis en avant n’a pas été publiée.
- La baie IXL144 comprend 144 GPU et 18 CPU, et son coût par million de jetons effectifs serait inférieur de 40 %.
- Un déploiement distinct répartissant le travail entre GPU et XPU aurait réduit la latence de décodage de 60 %.
- L’événement a également porté sur l’automatisation logicielle et les applications de la TY1200 en IA locale et en simulation robotique.