Une chaîne de montage plus rapide met l’approvisionnement en mémoire au centre des enjeux
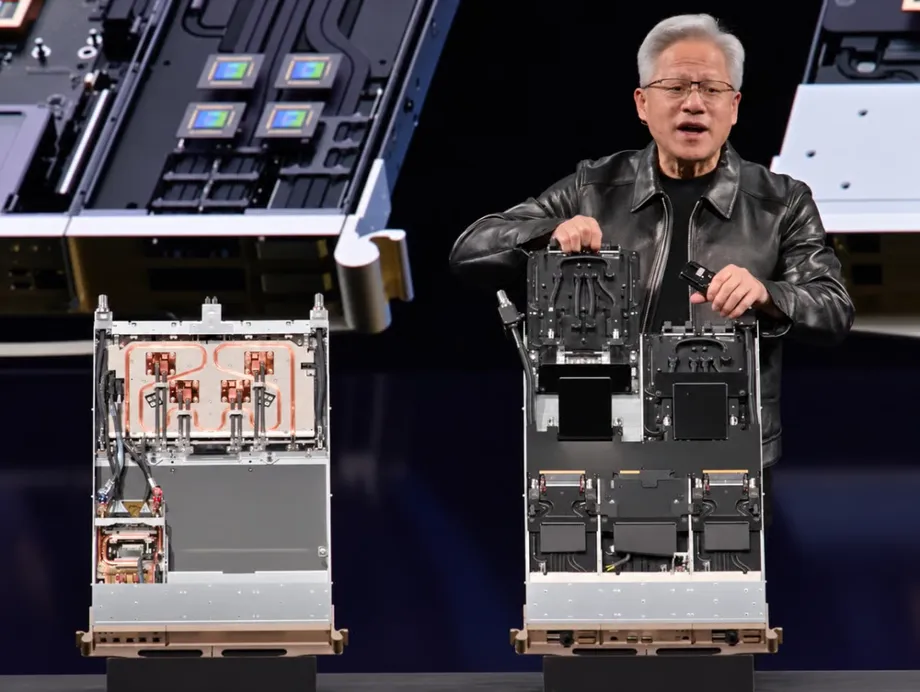
Nvidia a lancé la production à grande échelle de sa plateforme de calcul dédiée à l’intelligence artificielle Vera Rubin. Son directeur général, Jensen Huang, a indiqué qu’un nœud serveur pouvait désormais être assemblé en moins de cinq minutes, contre deux heures pour son prédécesseur, Grace Blackwell. Cette évolution promet d’accélérer la fabrication des serveurs tout en stimulant la demande de mémoire avancée fournie par Samsung Electronics, SK hynix et Micron.
Sommaire
- Une chaîne de montage plus rapide met l’approvisionnement en mémoire au centre des enjeux
- Qu’est-ce qui change dans Vera Rubin ?
- Pourquoi la HBM4 compte pour les performances de l’IA
- Samsung mise sur la vitesse, SK hynix sur la capacité
- Micron augmente ses capacités, déjà réservées pour 2027
- L’assemblage et la main-d’œuvre peuvent ralentir les livraisons
- La HBM4E est déjà en préparation
- Les fabricants explorent d’autres solutions que la mémoire à côté du GPU
- Les étapes de production à suivre
- À retenir
Huang a présenté le nœud Vera Rubin lors du GTC Berlin 2026, décrivant une conception sans câble ni fil et entièrement refroidie par liquide. Grace Blackwell utilisait le refroidissement liquide pour 80 % du système et nécessitait un assemblage nettement plus complexe.
La comparaison correspond à une réduction de plus de 95,8 %, de 120 minutes à moins de cinq. Pour les entreprises qui construisent de grandes quantités de serveurs d’IA, simplifier cette étape pourrait accélérer leur passage en usine. Le temps nécessaire à la fabrication des puces, à l’assemblage de la mémoire et à l’installation des systèmes complets reste intégré au calendrier général de production.
Samsung et SK hynix se disputent la demande qui en découle pour la HBM4, la sixième génération de mémoire à large bande passante. Micron est également qualifié pour fournir Vera Rubin : les trois principaux fabricants de HBM sont donc en lice.
Dans le même temps, les fournisseurs présentent déjà la HBM4E, la génération qui succédera à la HBM4. Leurs annonces révèlent deux enjeux liés : Nvidia veut des serveurs plus faciles à assembler, tandis que les fabricants de mémoire doivent offrir davantage de vitesse et de capacité au terme d’un processus de production complexe. Une fabrication plus rapide des serveurs renforce encore la valeur de livraisons de puces fiables.
Qu’est-ce qui change dans Vera Rubin ?
Un nœud serveur est un élément constitutif d’un système informatique plus vaste. Nvidia relie ces unités afin que de nombreux processeurs puissent travailler ensemble sur des tâches d’IA exigeantes, comme l’entraînement d’un modèle ou le traitement des requêtes d’un grand nombre d’utilisateurs.
La conception simplifiée de Vera Rubin réduit le travail nécessaire pour relier les composants. Dans sa comparaison avec Grace Blackwell, Huang a mis l’accent sur la suppression des câbles et des fils dans le nœud, ainsi que sur le passage à un refroidissement entièrement liquide.
Le refroidissement liquide évacue la chaleur des composants grâce à un fluide en circulation. Les puissants processeurs d’IA dégagent beaucoup de chaleur ; maîtriser la température contribue à leur bon fonctionnement lors de charges de travail soutenues. Vera Rubin étend cette approche à l’ensemble du système décrit par Huang.
L’annonce de Nvidia marque le passage de la conception à la fabrication. Le rythme auquel les systèmes finis parviendront aux clients dépendra également de la disponibilité des processeurs, de la mémoire, des capacités d’assemblage et des équipements de refroidissement.
Pourquoi la HBM4 compte pour les performances de l’IA
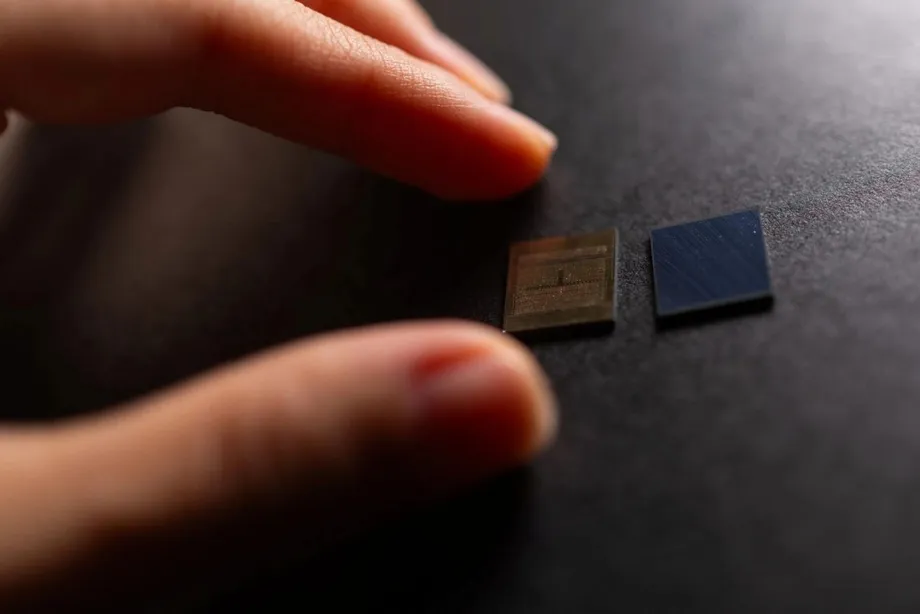
La HBM empile verticalement plusieurs puces mémoire à côté d’un processeur d’IA. De minuscules connexions traversant le silicium permettent aux données de circuler entre les couches. Une surface de connexion commune relie la pile au processeur, qui peut ainsi accéder rapidement aux informations.
Les processeurs d’IA ont besoin de cet accès, car leurs calculs reposent sur un approvisionnement constant en données. Un processeur puissant peut se retrouver à attendre si sa mémoire ne lui transmet pas les informations assez rapidement. La bande passante désigne la quantité de données pouvant circuler chaque seconde ; la capacité correspond au volume pouvant être stocké à un instant donné.
La HBM4 élargit l’interface de données à 2 048 bits, soit le double de la génération précédente. Samsung annonce une bande passante de 2,8 téraoctets par seconde pour sa pile de 12 couches, tandis que Micron fait état de plus de 2,8 téraoctets par seconde pour son produit HBM4 actuel.
La vitesse et l’espace de stockage comptent tous deux. L’entraînement d’un modèle d’IA nécessite des calculs répétés sur de grandes quantités de données. L’exécution d’un modèle entraîné, appelée inférence, exige aussi de la mémoire pour stocker le modèle et les informations relatives aux requêtes en cours de traitement.
Samsung mise sur la vitesse, SK hynix sur la capacité
La HBM4 de Samsung associe son procédé de fabrication DRAM 1c de sixième génération à une puce de base conçue selon un procédé logique de 4 nanomètres. La puce de base est la couche de contrôle située sous la pile mémoire. Samsung annonce un débit de 11,7 gigabits par seconde par broche, pouvant atteindre 13 gigabits dans des configurations optimisées.
Hwang Sang-joon, responsable du développement des mémoires chez Samsung Electronics, a expliqué ce choix de fabrication lors de l’annonce des premières livraisons commerciales de l’entreprise :
Au lieu de suivre la voie conventionnelle consistant à utiliser des conceptions existantes éprouvées, Samsung a fait le pari d’adopter les nœuds les plus avancés, comme la DRAM 1c et le procédé logique de 4 nm, pour la HBM4.
SK hynix a adopté une approche différente pour son produit HBM4 présenté, en utilisant son procédé DRAM 1b, plus éprouvé, et en empilant 16 couches. Cette version offre une capacité de 48 gigaoctets, contre 36 gigaoctets pour la pile de 12 couches de Samsung.
La pile de SK hynix offre donc 12 gigaoctets de plus, soit une hausse de capacité d’un tiers. Cet espace supplémentaire peut aider les systèmes à conserver davantage de données de travail à proximité du processeur. L’approche de Samsung privilégie des transferts plus rapides grâce à un procédé de fabrication plus récent.
La capacité est particulièrement précieuse pour les longues conversations et les tâches d’IA complexes. Les modèles conservent des informations sur les premières parties d’une requête dans une mémoire temporaire appelée cache clé-valeur. Lorsque davantage d’utilisateurs soumettent des requêtes plus longues, ce cache peut remplir la mémoire disponible et obliger à transférer des informations vers un stockage plus lent.
Ahn Hyeon, responsable du développement chez SK hynix, a estimé que les besoins de performance des infrastructures d’IA pourraient être environ 20 fois plus importants en 2030 qu’en 2026. Son argument en faveur de nouvelles technologies de mémoire repose en partie sur la quantité croissante d’informations que les systèmes d’inférence doivent garder rapidement accessibles.
Micron augmente ses capacités, déjà réservées pour 2027
Micron a inauguré sa deuxième usine avancée d’assemblage et de test de HBM à Taichung, à Taïwan, à la mi-octobre 2026. Le site, baptisé AATT2, augmente les capacités de transformation des puces mémoire individuelles en piles finies.
Manish Bhatia, président et directeur de l’exploitation de Micron, a décrit la demande lors de la cérémonie d’inauguration :
Toute la capacité prévue pour 2027 est déjà vendue.
Le directeur général de Micron, Sanjay Mehrotra, a déclaré lors de la conférence téléphonique sur les résultats de juin que les ventes cumulées de HBM4 avaient dépassé le milliard de dollars quelques mois après le début des livraisons commerciales. Il a également indiqué que la montée en cadence de la production de HBM4 à 12 couches était deux fois plus rapide que celle de la HBM3E équivalente.
En juin, Huang, de Nvidia, a confirmé que Samsung, SK hynix et Micron avaient tous obtenu la qualification HBM4 et lancé la production de masse pour Vera Rubin. La qualification par un client signifie que le produit du fournisseur a passé les contrôles requis pour être utilisé dans le système de ce client.
Micron visait une capacité totale de production de HBM d’environ 100 000 tranches par mois d’ici à la fin de 2026. En juin, ses investissements cumulés à Taïwan dépassaient 1 600 milliards de dollars taïwanais, soit environ 50,2 milliards de dollars.
Le site de Tongluo, dans le comté de Miaoli, devrait commencer à livrer ses produits en volume d’ici à la mi-2027. Les tranches produites sur ce site parcourraient environ 24 kilomètres jusqu’à AATT2 pour y être assemblées et testées, reliant ainsi deux étapes de la production sur une distance relativement courte.
L’assemblage et la main-d’œuvre peuvent ralentir les livraisons
La production de HBM ne se limite pas à la fabrication d’une puce mémoire fonctionnelle. Les fabricants doivent amincir le silicium, y créer des connexions précises et solidariser plusieurs couches. Un défaut à l’une de ces étapes peut réduire le nombre de piles finies utilisables.
Des piles plus hautes augmentent le nombre de connexions et d’opérations d’assemblage qui doivent réussir. Le choix de Samsung d’un procédé plus récent avec 12 couches et celui de SK hynix d’un procédé plus éprouvé avec 16 couches impliquent donc des défis de fabrication différents, en plus de caractéristiques distinctes.
Le fournisseur d’équipements Hanmi Semiconductor propose des machines de thermocompression, qui assemblent les couches à l’aide d’une chaleur et d’une pression contrôlées avec précision. En juin, SK hynix a signé un contrat de 44,2 milliards de wons, soit environ 33 millions de dollars, portant sur des équipements TC Bonder 4.5 Griffin améliorés destinés à son usine de Cheongju. Hanmi prévoit de commercialiser son prochain Wide TC Bonder en 2027.
Micron est également confronté à des incertitudes concernant la main-d’œuvre à Taïwan. Son syndicat de Taoyuan a indiqué que 1 994 de ses 2 012 membres habilités avaient approuvé une action de grève le 7 octobre, soit environ 99 % des membres concernés. Une médiation impliquant le syndicat de Taichung était prévue le 22 octobre. Le président taïwanais Lai Ching-te a participé à l’inauguration d’AATT2 et appelé à des négociations de bonne foi.
Ces événements attirent l’attention sur les effectifs autant que sur les équipements des usines. L’autorisation de faire grève constituait une étape permettant une action syndicale ; aucun débrayage ni aucune perturbation des livraisons qui en résulterait n’avaient été annoncés.
La HBM4E est déjà en préparation
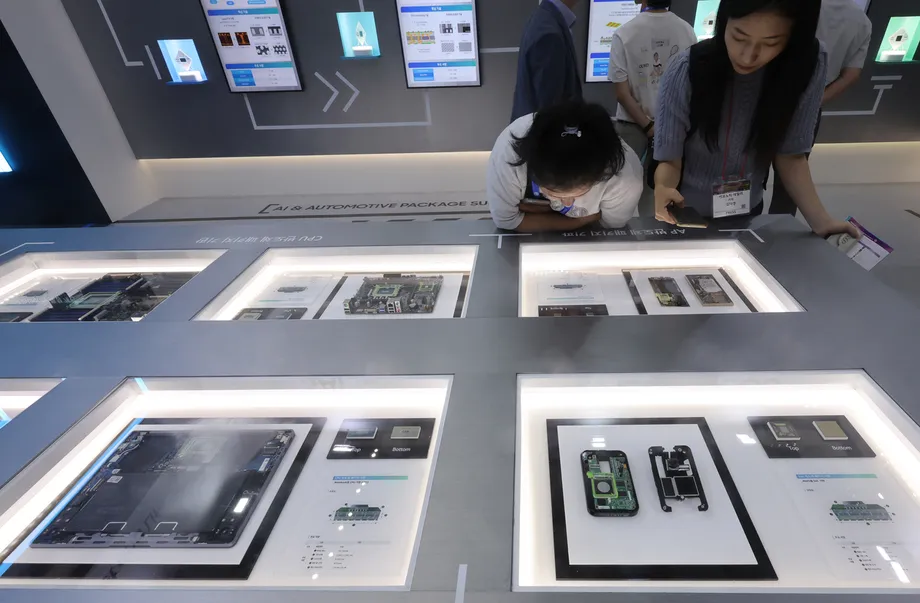
Samsung et SK hynix ont présenté leur technologie HBM4E de nouvelle génération au SEDEX 2026, qui s’est tenu du 14 au 16 octobre au COEX, à Séoul. Les deux entreprises ont également exposé le Superchip Vera Rubin de Nvidia, illustrant le lien étroit entre la concurrence dans le secteur de la mémoire et la plateforme de Nvidia.
La HBM4E de Samsung utilise de la DRAM 1c et une puce de base fabriquée selon un procédé de 4 nanomètres. L’entreprise annonce des débits pouvant atteindre 16 gigabits par seconde par broche et une bande passante de 3,6 téraoctets par seconde.
Par rapport aux 2,8 téraoctets par seconde annoncés par Samsung pour la HBM4, cela représente une hausse d’environ 29 %. Sa pile HBM4E de 12 couches offre une capacité de 48 gigaoctets, soit un tiers de plus que les 36 gigaoctets de sa pile HBM4 comportant le même nombre de couches. Samsung prévoit également des versions de huit couches et 32 gigaoctets, ainsi que de 16 couches et 64 gigaoctets.
SK hynix a également présenté sa HBM4E, avec des débits pouvant atteindre 16 gigabits par seconde par broche, et annoncé une amélioration de l’efficacité énergétique de plus de 20 % par rapport à la HBM4. Samsung a fourni des échantillons à ses clients en mai, puis SK hynix en juin, pour des tests de performance. Samsung vise une production de masse conforme aux calendriers de ses clients.
Les fabricants explorent d’autres solutions que la mémoire à côté du GPU
Samsung a présenté une maquette de la zHBM, une architecture qui place la mémoire à la verticale, au-dessus d’une puce de calcul, plutôt qu’à côté. Réduire la distance entre les deux pourrait limiter le temps et l’énergie consacrés au transfert des données.
SK hynix a présenté la mémoire flash à large bande passante, ou HBF, dont la capacité devrait être environ 10 fois supérieure à celle de la HBM actuelle. Cette technologie proposée ajouterait un niveau intermédiaire entre la mémoire rapide et le stockage, afin d’aider les systèmes d’IA à gérer davantage de données.
Samsung a également montré une mémoire capable d’effectuer certains calculs en interne. Cette approche vise à réduire la fréquence des transferts de données vers un processeur distinct. Chacune de ces propositions s’attaque à un problème connexe : le transfert d’informations prend du temps et consomme de l’énergie, même lorsque la puce de calcul est extrêmement rapide.
La zHBM et la HBF en sont encore aux stades de la conception et du développement ; leurs dates de commercialisation et leur adoption par les clients ne sont pas encore arrêtées. Pour la production actuelle de Vera Rubin, la fabrication et la livraison de HBM4 restent les priorités immédiates.
Les étapes de production à suivre
Le passage de Nvidia à la production à grande échelle intervient après plusieurs mois de qualification des mémoires, d’expansion des usines et de présentation de produits futurs. Les principales étapes montrent que les calendriers des processeurs et de la mémoire sont de plus en plus étroitement liés :
- Début 2026 : la HBM4 de Micron entre en production de masse.
- Mai et juin 2026 : Samsung et SK hynix fournissent des échantillons de HBM4E à leurs clients.
- Juin 2026 : Huang confirme que les trois principaux fournisseurs de HBM sont qualifiés et produisent pour Vera Rubin.
- 7 octobre 2026 : le syndicat de Micron à Taoyuan approuve une action de grève.
- Du 14 au 16 octobre 2026 : Samsung et SK hynix présentent des technologies de mémoire au SEDEX, à Séoul.
- Mi-octobre 2026 : Micron inaugure son usine d’assemblage et de test AATT2 à Taichung.
- 22 octobre 2026 : une médiation impliquant le syndicat de Micron à Taichung est prévue.
- Mi-2027 : Micron vise le lancement des livraisons en volume depuis son site agrandi de Tongluo.
Samsung et SK hynix pourraient tirer parti des besoins croissants de Vera Rubin en mémoire, tandis que les capacités de Micron déjà réservées témoignent d’une forte concurrence pour les approvisionnements disponibles. Les clients ont besoin de systèmes complets : l’assemblage rapide des nœuds doit donc s’accompagner de capacités suffisantes en mémoire, d’un assemblage fiable et d’une exploitation sans accroc des usines.
À retenir
- Nvidia annonce que Vera Rubin est en production à grande échelle et que l’assemblage d’un nœud prend moins de cinq minutes, contre deux heures auparavant.
- La plateforme utilise un refroidissement entièrement liquide et de la HBM4 fournie par les fabricants qualifiés Samsung, SK hynix et Micron.
- La pile HBM4 de Samsung à 12 couches offre une capacité de 36 gigaoctets ; celle de 16 couches présentée par SK hynix en offre 48.
- Micron indique que toute la capacité prévue pour 2027 dans sa nouvelle usine de HBM à Taichung est déjà réservée.
- L’assemblage avancé, la disponibilité des équipements et les négociations sur la main-d’œuvre restent des facteurs concrets qui pèsent sur les calendriers de livraison.
- Samsung et SK hynix testent la HBM4E tout en développant de nouvelles façons de positionner et d’organiser la mémoire destinée à l’IA.