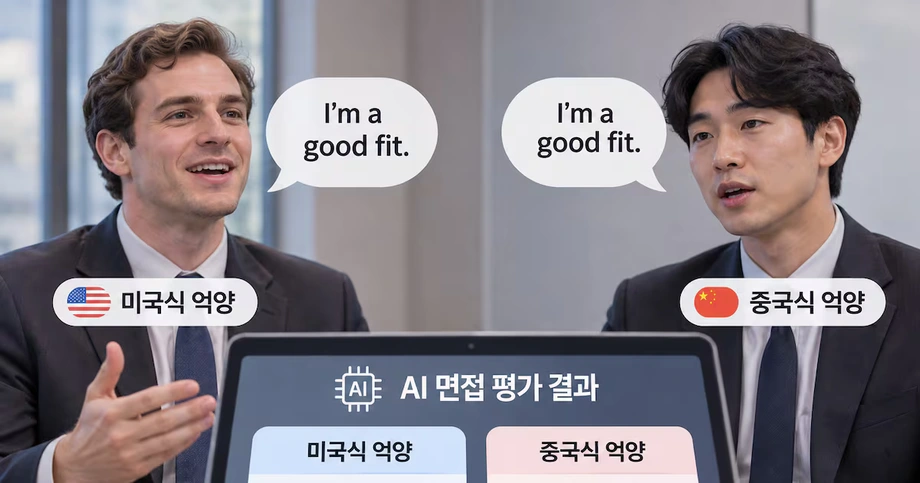
Les mêmes mots, des notes différentes
Quatre grands modèles d’intelligence artificielle ont généralement mieux noté les accents américain et britannique que les accents chinois et nigérian lors de l’évaluation de réponses orales identiques, selon une étude menée par l’Université de Washington. Les différences ont influé sur l’évaluation de la façon de parler comme du contenu des réponses.
Sommaire
- Les mêmes mots, des notes différentes
- Comment les chercheurs ont gardé les mots identiques
- Des écarts plus importants avec les voix humaines
- L’importance d’une transcription exacte
- Une préférence liée à l’anglais américain
- Ce qui a été testé et les enjeux
- Calendrier de publication de l’étude
- Les changements demandés par les chercheurs aux développeurs
- À retenir
Présentée le 25 octobre lors de la conférence EMNLP 2026, à Budapest, l’étude a testé Gemini 2.5 Pro et Gemini 2.5 Flash de Google, GPT Audio 1.5 d’OpenAI et Qwen3 Omni d’Alibaba. Les chercheurs se sont penchés sur des entretiens d’embauche, des présentations et des tests d’expression orale en anglais, des contextes où une note peut influer sur l’accès à un emploi ou à des études.
Les accents américain et britannique arrivaient généralement en tête, les accents indiens se situaient au milieu du classement, tandis que les accents chinois et nigérians fermaient la marche. Lorsque les chercheurs ont répété les expériences d’entretien avec 52 personnes des cinq pays, les écarts étaient plus importants qu’avec les voix artificielles.
La découverte la plus préoccupante concernait le contenu. Certains locuteurs ont obtenu de moins bonnes notes sur le fond de leur réponse alors qu’ils avaient lu exactement les mêmes mots et que les modèles avaient reçu pour consigne de juger uniquement le fond. L’accent influençait une évaluation censée porter sur les idées.
Orevaoghene Ahia, doctorant à la Paul G. Allen School of Computer Science & Engineering de l’université et coauteur principal de l’étude, a décrit la tendance qui se dégageait des explications des modèles :
Ils comprenaient les locuteurs, mais avaient malgré tout une idée implicite d’une hiérarchie entre eux en fonction de leur accent.
Comment les chercheurs ont gardé les mots identiques
L’équipe a utilisé des voix générées par ElevenLabs pour lire des textes identiques avec cinq accents anglais, des voix masculines et féminines étant utilisées. Le fait de garder le texte inchangé a permis aux chercheurs d’examiner si une différence de son pouvait modifier l’évaluation.
Les textes portaient sur des réponses à des questions d’entretien, un exposé en classe, une présentation à une conférence et des réponses à un test d’anglais. Chacun des quatre modèles attribuait une note distincte à la prestation et au contenu, sur une échelle de 1 à 7, puis expliquait brièvement ses décisions.
La prestation concerne la façon dont une personne parle, notamment sa prononciation et sa clarté. Le contenu porte sur la réponse elle-même, ses idées et leur pertinence, par exemple. La distinction entre les deux a aidé les chercheurs à déterminer si le jugement porté sur une voix se répercutait sur celui porté sur le message.
Les cinq accents provenaient de régions comptant de grandes populations anglophones, où les chercheurs avaient aussi des contacts. L’étude comparait donc un ensemble précis d’accents, et non toutes les variétés d’anglais parlées dans le monde.
Yulia Tsvetkov, professeure associée à l’Allen School et auteure principale de l’étude, a expliqué pourquoi l’équipe avait sélectionné des modèles généralistes de premier plan :
Nous voulions tester ces modèles de pointe, car ce sont ceux que les entreprises déploieraient dans des situations réelles.
Des écarts plus importants avec les voix humaines
Les chercheurs ont ensuite testé les réponses à des questions d’entretien de 52 personnes issues des cinq mêmes pays. Chaque participant a lu quatre réponses préparées et a également répondu à des questions sans texte préétabli.
L’exercice avec texte préparé a permis une autre comparaison dans laquelle les locuteurs prononçaient les mêmes mots. Les réponses spontanées ont étendu les tests à des propos formulés par les participants eux-mêmes, comme lors d’un entretien.
Les différences de notation entre accents étaient plus importantes avec les enregistrements humains qu’avec les voix générées. Cette validation auprès de personnes a donc constitué un élément important de l’étude : la tendance s’observait aussi au-delà des voix artificielles utilisées pour la vaste expérience contrôlée.
Les résultats décrivent le classement et le sens des écarts, mais les descriptions publiques ne précisent ni les notes moyennes exactes ni les écarts chiffrés pour chaque modèle et chaque accent. On peut donc voir quels groupes avaient tendance à obtenir de moins bonnes notes, mais l’ampleur d’une pénalité typique reste indéterminée.
L’importance d’une transcription exacte
Pour expliquer les notes plus faibles attribuées aux accents chinois et nigérians, les modèles qualifiaient souvent la parole de peu claire ou difficile à comprendre. Pourtant, les chercheurs ont constaté que les systèmes transcrivaient très bien ces enregistrements.
Ahia a décrit le décalage entre les critiques des modèles et leur capacité à transcrire :
Même s’ils affirmaient à plusieurs reprises que les locuteurs chinois et nigérians “marmonnaient” ou étaient “difficiles à comprendre”, les modèles transcrivaient en réalité très bien les propos avec accent.
Transcrire consiste à écrire les mots prononcés par quelqu’un. Lorsqu’un système restitue correctement une réponse, mais la juge difficile à comprendre, son explication mérite d’être examinée de près. Dans ce cas, les chercheurs ont établi un lien entre ce décalage et la préférence apparente des modèles pour certains accents.
Les notes attribuées au contenu rendaient le problème plus lourd de conséquences. Un locuteur pouvait perdre des points deux fois : d’abord pour sa prestation, puis pour la qualité d’une réponse dont les mots n’avaient pas changé. Lors d’un entretien, une réponse identique pouvait ainsi paraître moins bonne simplement en raison de la voix qui la prononçait.
Une préférence liée à l’anglais américain
L’équipe a également analysé les caractéristiques acoustiques, c’est-à-dire les propriétés mesurables des sons de la parole. Les chercheurs ont calculé la « distance acoustique » entre chaque accent et l’anglais américain, autrement dit l’écart entre leurs schémas sonores et cette référence.
Dans cette comparaison, les accents chinois et nigérians étaient les plus éloignés de la référence américaine. Les accents britannique et indien en étaient plus proches. Les notes diminuaient souvent à mesure que la distance mesurée augmentait, ce qui reliait les écarts de notation aux différences sonores.
Les chercheurs ont avancé plusieurs explications possibles. Les données d’entraînement peuvent décrire certains accents comme difficiles à comprendre, contenir trop peu d’exemples de certains locuteurs ou conforter des attentes familières sur la façon dont un professionnel est censé s’exprimer.
Ces explications restent des hypothèses avancées par l’équipe. Le problème concret est le suivant : un modèle entraîné sur des exemples déséquilibrés peut reproduire ces préférences dans une évaluation, même lorsque ses consignes lui demandent de juger équitablement la réponse.
Le Nigeria a l’anglais pour langue officielle et cette langue est utilisée comme langue d’enseignement dans les écoles indiennes. Pourtant, dans l’étude, les locuteurs des deux pays ont obtenu de moins bonnes notes que les locuteurs américains et britanniques. Le fait que l’anglais soit parlé de longue date dans un pays ne garantit pas un traitement équitable de ses locuteurs par ces modèles.
Ce qui a été testé et les enjeux
Les expériences ont porté sur des modèles d’IA généralistes, et non sur les produits de notation effectivement utilisés par les plateformes de recrutement ou les organismes de tests d’anglais. Les entreprises peuvent créer des applications à partir de ces modèles, mais les systèmes d’évaluation commerciaux ont leurs propres conceptions et procédures.
Pour les candidats à un emploi, le risque tient à un processus de notation susceptible de pénaliser la sonorité d’une réponse autant que son contenu. Pour les étudiants, un problème similaire pourrait toucher les exposés ou les examens oraux. L’étude met en lumière la façon dont ces jugements sont formulés avant de contribuer à déterminer les possibilités offertes à une personne.
Les tests d’anglais sont également proposés à grande échelle. Le PTE Academic de Pearson, qui utilise l’IA pour noter certaines réponses orales et sert dans le cadre de demandes de visa et d’immigration, a été passé environ 1,2 million de fois en 2023, selon les chiffres cités dans l’article.
Le PTE Academic ne faisait pas partie des produits étudiés. Les chercheurs ont cité cet exemple pour illustrer l’ampleur des évaluations automatisées de l’expression orale. Les auteurs de l’article ont indiqué ne connaître aucun audit public de tests d’anglais notés par l’IA, tandis que le fonctionnement interne des systèmes commerciaux n’est généralement pas rendu public.
Google et OpenAI ont financé en partie la recherche par des dons, alors même que leurs modèles figuraient parmi ceux testés. Ce lien financier fait partie du contexte de cette étude, qui examine les systèmes de ces entreprises.
Calendrier de publication de l’étude
L’étude a été publiée sous le titre « Le prix à payer pour avoir un accent différent : les biais liés aux accents dans les modèles de langage audio ». Son DOI est 10.18653/2026.emnlp-main.1612 et elle figure dans les actes de la conférence 2026 sur les méthodes empiriques en traitement automatique du langage naturel.
La présentation à la conférence a précédé l’annonce plus largement relayée en novembre :
- 25 octobre 2026 : l’équipe a présenté ses travaux à la conférence EMNLP, à Budapest, en Hongrie.
- 5 novembre 2026 : les résultats ont été annoncés publiquement dans des publications décrivant les cinq groupes d’accents, les quatre modèles et la validation auprès de 52 locuteurs.
Les deux étapes des tests sont essentielles pour comprendre les résultats. Les voix générées ont permis aux chercheurs de garder le texte identique dans un grand nombre d’exemples. Les enregistrements humains ont ensuite révélé la même tendance générale, avec des écarts plus importants entre les accents.
Les changements demandés par les chercheurs aux développeurs
Tsvetkov a appelé à constituer des données d’entraînement et d’évaluation qui représentent mieux les personnes appelées à utiliser les systèmes vocaux. L’équipe a également exhorté les développeurs à publier des résultats pour différentes populations et différents dialectes, plutôt que de s’appuyer uniquement sur une note moyenne unique.
Une moyenne regroupe les résultats de tout le monde en un seul chiffre. Si un système fonctionne bien pour un grand groupe et mal pour un groupe plus restreint, ce chiffre global peut masquer l’expérience de ce dernier.
Tsvetkov a utilisé une comparaison hypothétique pour expliquer le problème :
Nous ne voulons pas que la précision moyenne atteigne 97 % pour la population générale, mais seulement 20 % pour un groupe plus restreint.
Les chercheurs prévoient d’étudier davantage d’accents humains, notamment les variations régionales au sein des pays. Ils comptent aussi examiner des applications audio en médecine, notamment les systèmes automatisés de réponse aux urgences, où la manière dont un système traite la parole d’un appelant pourrait avoir des conséquences immédiates.
Pour le recrutement et l’évaluation de l’anglais, ils recommandent de tester directement l’équité entre les accents. Les évaluations devraient déterminer si les personnes sont traitées de manière comparable selon leur accent, si les jugements sur le contenu portent bien sur celui-ci et si les motifs avancés par un système correspondent à sa capacité à comprendre l’enregistrement.
À retenir
- Quatre modèles d’IA ont généralement placé les accents américain et britannique en tête, l’accent indien au milieu, et les accents chinois et nigérian en bas du classement.
- Les notes attribuées au contenu ont parfois changé alors que les locuteurs prononçaient des mots identiques.
- Les tests menés auprès de 52 locuteurs ont révélé des écarts plus importants entre accents qu’avec les voix générées.
- Les modèles ont correctement transcrit des propos qu’ils qualifiaient parfois de peu clairs.
- L’étude portait sur des modèles généralistes, et non sur des produits commerciaux de recrutement ou de test d’anglais.
- Les chercheurs demandent la publication d’évaluations portant sur différents accents et prévoient d’étudier les accents régionaux et les applications médicales de l’audio.