Une mise à niveau du modèle arrive avec un service de recherche accessible au public
DeepSeek a publié V4.1-Flash-1017 le 17 octobre 2026, en mettant à jour simultanément son site web, son application et son API, tout en ouvrant deux services permettant aux développeurs de faire des recherches sur le web et de récupérer des pages individuelles. L’entreprise fixe le tarif de chaque point d’accès Search et Fetch à 0,75 $ pour 1 000 appels. La facturation des appels éligibles via les outils serveur commencera à 16 h 00 UTC le 31 octobre, soit à minuit le 1er novembre à Pékin.
Sommaire
- Une mise à niveau du modèle arrive avec un service de recherche accessible au public
- Ce que signifie concrètement la programmation à partir d’une demande
- Les gains sont les plus marqués sur certains benchmarks
- Pourquoi des réponses plus courtes peuvent réduire le coût des tâches
- Search trouve des pages, Fetch les récupère
- Tarifs et calendrier pour les développeurs
- Les mises à jour du harness rapprochent le modèle du travail quotidien
- Poids ouverts et choix de déploiement
- Les dates clés du déploiement
- Points clés
Cette version paraît 37 jours après la première publication de V4.1 Flash, le 10 septembre. Les développeurs peuvent continuer à utiliser le nom du modèle deepseek-flash ; la méthode d’appel de l’API du modèle et ses tarifs restent inchangés. DeepSeek publie également le modèle mis à jour en accès libre sur Hugging Face et ModelScope.
Dans son annonce officielle de sortie, DeepSeek place au cœur de cette mise à jour le développement complet de projets. Parmi les exemples présentés figurent une modélisation de la Cité interdite de Pékin, un jeu de course dans un navigateur, une recréation de Portal 2 avec le moteur Godot et une scène 3D animée retraçant l’histoire de la préhistoire à l’époque moderne.
DeepSeek affirme que le modèle est plus performant, tout en nécessitant moins de temps et en produisant des réponses plus courtes. Pour les développeurs, ces améliorations réduisent deux coûts à la fois : le temps pendant lequel une tâche automatisée mobilise un ordinateur et le volume de texte généré facturé par le service de modèles.
Le lancement de la recherche ajoute un autre élément à ce flux de travail. Une application d’IA peut désormais utiliser le modèle de DeepSeek pour planifier une tâche, son moteur de recherche pour trouver des informations récentes et son service Fetch pour intégrer une page web sélectionnée à la tâche.
Ce que signifie concrètement la programmation à partir d’une demande
DeepSeek décrit l’ambition centrale du projet comme une programmation à partir du souhait de l’utilisateur : une personne explique ce qu’elle veut en langage courant, et l’IA prend en charge une plus grande partie du travail nécessaire pour transformer cette demande en un projet fonctionnel.
Les quatre démonstrations couvrent différents types de travaux. L’exemple de la Cité interdite porte sur la modélisation 3D. Le jeu de course nécessite des interactions dans un navigateur. La recréation de Portal 2 repose sur un moteur de jeu existant, Godot. Valley of Ages présente des environnements qui évoluent au fil d’une longue période de l’histoire humaine.
DeepSeek indique que ces projets ont été réalisés dans DeepSeek Harness avec relativement peu de requêtes, peu de documents de référence et un nombre limité d’allers-retours. L’entreprise attribue les progrès à l’apprentissage par renforcement avec rétroaction propre, une méthode d’entraînement dans laquelle les retours sur les tentatives précédentes contribuent à façonner les comportements ultérieurs.
Un « harness » est le logiciel qui entoure un modèle de langage et gère les outils, les fichiers, les sessions et l’exécution des tâches. Le modèle peut proposer du code ou décider de la prochaine étape ; le harness fournit l’environnement dans lequel ces actions sont effectuées. Le logiciel qui l’entoure fait donc partie du processus de développement du projet, au même titre que le modèle lui-même.
Les gains sont les plus marqués sur certains benchmarks
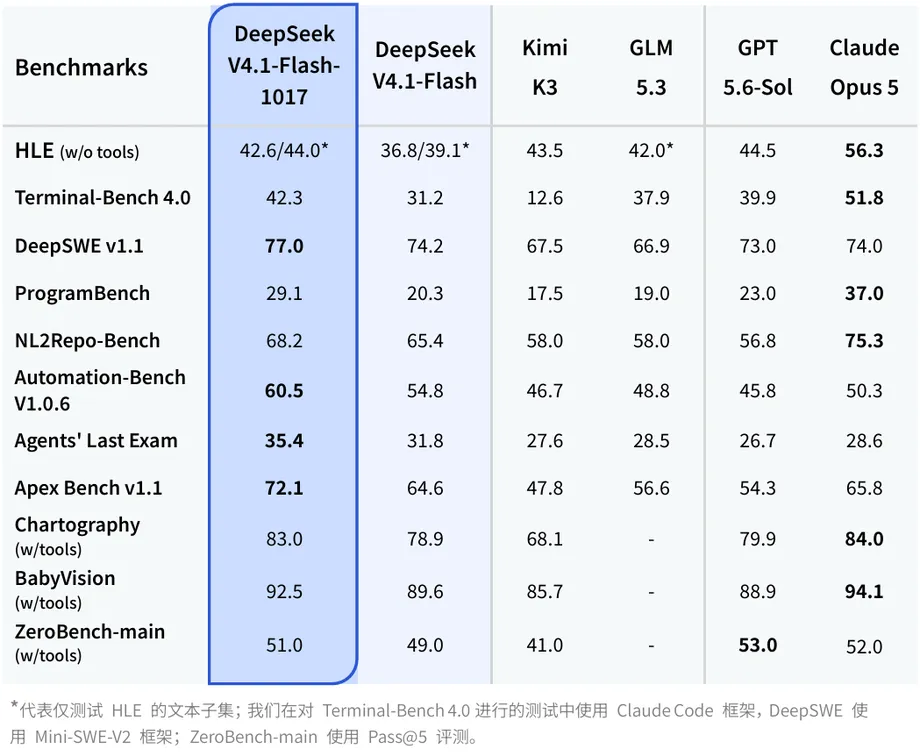
Dans les évaluations publiées par DeepSeek, le modèle mis à jour obtient 77,0 sur DeepSWE v1.1, contre 74,2 pour la version de septembre. Cela représente un gain de 2,8 points sur une évaluation de tâches de génie logiciel. Dans la comparaison de l’entreprise, Claude Opus 5 obtient 74,0 et GPT 5.6-Sol, 73,0.
Sur Terminal-Bench 4.0, la progression par rapport à la version Flash précédente est plus importante : le score passe de 31,2 à 42,3, soit une hausse de 11,1 points. ProgramBench progresse de 20,3 à 29,1, tandis que NL2Repo-Bench passe de 65,4 à 68,2.
DeepSeek signale également des progrès sur les tâches faisant intervenir des agents, c’est-à-dire des systèmes qui utilisent des outils pour exécuter une série d’actions. Automation-Bench v1.0.6 passe de 54,8 à 60,5, Agents' Last Exam de 31,8 à 35,4 et Apex Bench v1.1 de 64,6 à 72,1.
Dans le tableau comparatif de DeepSeek, le modèle mis à jour arrive en tête sur DeepSWE, Automation-Bench, Agents' Last Exam et Apex Bench, devant les modèles répertoriés d’Anthropic, d’OpenAI, de Kimi et de Zhipu. Claude Opus 5 obtient de meilleurs résultats sur plusieurs autres évaluations, dont Terminal-Bench, ProgramBench et NL2Repo.
Les conditions de test comptent pour interpréter ces chiffres. DeepSeek attribue un score de 42,3 à Terminal-Bench 4.0, tandis qu’une évaluation d’Artificial Analysis indique 26,8. Les paramètres détaillés permettant d’expliquer cet écart ne sont pas précisés. DeepSeek indique que Claude Code a servi d’environnement pour Terminal-Bench et Mini-SWE-V2 pour DeepSWE, ce qui illustre la manière dont le modèle et les outils qui l’entourent sont évalués conjointement.
Pourquoi des réponses plus courtes peuvent réduire le coût des tâches
DeepSeek qualifie cette mise à jour d’amélioration de Pareto en matière de performances et de coûts. En clair, l’entreprise affirme que les utilisateurs obtiennent de meilleurs résultats tout en dépensant moins, plutôt que de devoir payer davantage pour une qualité supérieure.
Les services de modèles facturent généralement les jetons, ces petites unités en lesquelles le texte est découpé pour être traité. Une réponse générée plus courte utilise moins de jetons de sortie. Un agent de programmation peut produire de nombreuses réponses au cours d’une même tâche ; réduire les sorties superflues à chaque étape peut donc diminuer la facture totale.
DeepSeek affirme également que la durée d’exécution des tâches a diminué. C’est important pour les projets impliquant des modifications, des tests et des appels d’outils répétés, lorsque l’utilisateur attend un résultat final plutôt qu’une simple réponse. L’entreprise décrit cette version technique comme une mise à jour mineure, tout en revendiquant des progrès en matière de raisonnement, de programmation, de tâches d’agent et d’évaluations visuelles.
Search trouve des pages, Fetch les récupère
Les services Search et Fetch de DeepSeek ont des fonctions distinctes. Search reçoit une requête et renvoie une liste de résultats classés. Fetch reçoit une page web précise et en récupère le titre et le contenu au format Markdown, un format texte simple qui conserve les titres, les listes et d’autres éléments de structure utiles.
Un développeur pourrait, par exemple, utiliser Search pour trouver la documentation actuelle d’un logiciel, puis Fetch pour récupérer la page pertinente avant de demander au modèle d’écrire du code. Les applications qui combinent des documents récupérés et des réponses générées sont souvent appelées systèmes de génération augmentée par récupération, ou RAG.
Ces services utilisent l’adresse de base api.deepseek.com et le même système d’identifiants d’API que le service de modèles de DeepSeek. Les points d’accès sont POST /v1/tools/search et POST /v1/tools/fetch. Ils renvoient des données JSON structurées que les logiciels peuvent lire et transmettre d’un outil à l’autre.
Search accepte des requêtes de 128 caractères maximum. Les développeurs peuvent demander entre un et 50 résultats, avec 10 résultats par défaut. Ceux-ci peuvent inclure des titres, des adresses, de brefs résumés, des résumés plus détaillés destinés aux modèles, des dates de publication et, lorsqu’elles sont disponibles, les pages complètes.
DeepSeek affirme que son moteur de recherche alimente déjà la recherche sur son site web et son API, et traite chaque jour des centaines de millions de requêtes dans le monde. L’entreprise décrit un index couvrant des centaines de milliards de pages web et la prise en charge de recherches dans plusieurs langues.
DeepSeek indique également filtrer les tentatives de manipulation du classement des résultats, les efforts visant à influencer les informations sélectionnées par l’IA générative et les contenus de faible qualité générés par l’IA. Ces mesures concernent les informations consultées par un agent avant qu’il rédige une réponse ou qu’il agisse à la demande de l’utilisateur.
Tarifs et calendrier pour les développeurs
Dans son annonce en anglais, DeepSeek fixe séparément le tarif de Search et de Fetch à 0,75 $ pour 1 000 appels chacun. Le tarif indiqué en chinois est de 5 yuans pour 1 000 appels par service. Un flux de travail effectuant une recherche puis récupérant une page utilise donc deux services facturés séparément.
Selon les règles de facturation publiées, Search est facturé s’il renvoie avec succès une liste de résultats non vide. Fetch est facturé s’il renvoie le contenu d’une page avec un code de réussite HTTP 200. Les requêtes échouées, les résultats vides et les délais d’attente dépassés ne sont pas facturés, et le nombre de résultats demandé ne modifie pas le prix de l’appel de recherche.
Au tarif indiqué en yuans, 1 000 recherches réussies suivies de 1 000 récupérations de pages réussies coûteraient 10 yuans en frais de recherche et de récupération. Le traitement par le modèle est facturé séparément. Cette distinction aide les développeurs à estimer le coût d’un agent qui recherche régulièrement des informations pendant son travail.
DeepSeek indique que les appels Search et Fetch effectués au moyen des outils serveur dans DeepSeek Harness, Claude Code et Codex sont temporairement gratuits pour les utilisateurs de l’API DeepSeek. La facturation de ces appels commencera à 16 h 00 UTC le 31 octobre 2026, soit le 1er novembre à 00 h 00 à Pékin. Cette exemption temporaire concerne ces appels d’outils ; les tarifs habituels du modèle restent applicables.
Chaque compte peut effectuer jusqu’à cinq requêtes Search par seconde et cinq requêtes Fetch par seconde, les deux limites étant calculées séparément. Fetch applique également des limites supplémentaires à chaque domaine de site web. Les requêtes dépassant le débit autorisé reçoivent une réponse HTTP 429, qui indique à l’application de ralentir.
Les mises à jour du harness rapprochent le modèle du travail quotidien
DeepSeek recommande Harness v0.2.1-rc.1 ou une version ultérieure pour le modèle mis à jour. Les lettres rc désignent une version candidate, préparée pour être testée avant sa publication définitive. Le modèle a été spécifiquement optimisé pour DeepSeek Harness, Tencent CodeBuddy, WorkBuddy et d’autres frameworks.
La version de Harness ajoute des moyens de découvrir des plugins à partir d’index personnalisés et de demander à un agent d’en créer un. Elle améliore également la gestion des dépendances lors de l’activation, de la désactivation, de la mise à jour ou de la suppression des plugins. Certaines modifications de plugins prennent effet immédiatement ; d’autres nécessitent un redémarrage.
Les développeurs disposent désormais d’interfaces permettant de lire et de modifier le répertoire de travail d’une session au moyen des kits de développement logiciel TypeScript et Python. Parmi les autres nouveautés figurent des outils expérimentaux d’inspection des sessions, la prise en charge de répertoires de travail Git séparés, ainsi que le masquage automatique des clés et des jetons présents dans les messages envoyés.
Cette version poursuit le développement du pont Claude Code Mods, testé dans une précédente version alpha de Harness. Ce travail avait alors produit trois exemples exécutables et en avait bloqué quatre autres faute d’interfaces ou de capacités d’affichage nécessaires. La couche de compatibilité reste expérimentale ; l’objectif annoncé est de tester l’intégration des extensions Claude Code dans les plugins Harness.
Les nouveaux utilisateurs de Harness bénéficient également de 6 yuans de crédit promotionnel, sans paiement initial. Ce crédit expire sept jours après son attribution et n’est disponible que dans la limite des fonds alloués. Sa courte durée de validité en fait une enveloppe de test temporaire pour les nouveaux utilisateurs.
Poids ouverts et choix de déploiement
L’annonce officielle de DeepSeek confirme que V4.1-Flash-1017 est disponible sur Hugging Face et ModelScope. Cette version poursuit la lignée V4.1 Flash sous licence MIT, qui autorise une large réutilisation sous réserve de ses conditions. Les développeurs peuvent donc choisir entre un service hébergé et l’exploitation du modèle sur leur propre infrastructure.
V4.1 Flash accepte du texte et des images, et produit du texte. Son architecture repose sur un mélange d’experts : certaines parties du modèle sont activées à chaque étape de traitement, au lieu de mobiliser le modèle entier pour chaque jeton. Les descriptions de l’architecture indiquent un modèle de base de 552 milliards de paramètres, dont 8 milliards sont actifs lors du traitement des entrées et 16 milliards lors de la génération des sorties.
Une fenêtre de contexte d’environ un million de jetons permet au modèle de traiter de grandes quantités de contenu au cours d’une même session. Pour un agent de programmation, cela peut inclure des instructions, des fichiers source, les échanges précédents et les résultats des outils. La fenêtre de contexte correspond au volume de contenu qu’il peut prendre en compte, tandis que la limite de sortie détermine la quantité qu’il peut générer en une réponse.
Les caractéristiques des déploiements hébergés peuvent varier. Une fiche d’API tierce indique une fenêtre de contexte de 1 048 576 jetons et une limite maximale de génération de 131 072 jetons, ainsi que l’appel de fonctions et des sorties structurées définies par un schéma JSON. L’appel de fonctions permet au modèle de solliciter un outil externe ; les sorties structurées donnent à l’application un format prévisible à traiter.
Cette même fiche propose un routage entre inference.net, DeepInfra et DeepSeek, en redirigeant les requêtes vers un autre fournisseur en cas d’erreur. Les développeurs peuvent désormais choisir entre l’accès au modèle, le routage entre fournisseurs et les services de recherche distincts, chacun ayant ses propres paramètres opérationnels et ses propres coûts.
Les dates clés du déploiement
La version d’octobre de DeepSeek associe une mise à jour du modèle, une version candidate de Harness et l’accès public à une infrastructure de recherche. Plus tôt, le 17 octobre, un outil automatisé de suivi des API avait repéré une entrée de modèle portant le suffixe 1017, qui a ensuite disparu. L’annonce ultérieure de DeepSeek a confirmé la sortie et la mise à jour de son site web, de son application et de son API.
Cette chronologie laisse aux développeurs un court délai pour mettre à jour leurs outils et examiner leur utilisation de la recherche avant la fin de la période temporaire de gratuité :
- 10 septembre 2026 : DeepSeek publie le modèle V4.1 Flash initial.
- 3 octobre 2026 : Harness v0.2.1-alpha.1 introduit le pont expérimental Claude Code Mods.
- 17 octobre 2026 : V4.1-Flash-1017 est déployé sur le site web, dans l’application et via l’API ; Search et Fetch sont ouverts aux développeurs, et une version candidate mise à jour de Harness devient disponible.
- 31 octobre 2026, à 16 h 00 UTC : début de la facturation des appels Search et Fetch éligibles via les outils serveur, soit le 1er novembre à minuit à Pékin.
Les développeurs qui utilisent déjà deepseek-flash reçoivent le modèle mis à jour sous le nom existant. Ceux qui utilisent Harness sont également invités à mettre à jour l’application qui l’entoure. Le changement concret réside dans un flux de travail plus intégré : un modèle entraîné pour des projets de plus longue durée, des outils pour exécuter les tâches et un service de recherche qui entraînera bientôt des frais d’utilisation distincts.
Points clés
- DeepSeek a publié V4.1-Flash-1017 le 17 octobre 2026 sur son site web, dans son application et via son API.
- Le modèle reste accessible sous le nom deepseek-flash ; la méthode d’appel de l’API du modèle et ses tarifs restent inchangés.
- DeepSeek annonce un score de 77,0 sur DeepSWE v1.1, contre 74,2 auparavant, ainsi que des tâches plus rapides et des réponses plus courtes.
- Les projets de démonstration comprennent une modélisation de la Cité interdite, un jeu de course dans un navigateur, une recréation de Portal 2 et Valley of Ages.
- Search et Fetch coûtent chacun 0,75 $, ou 5 yuans selon le tarif chinois, pour 1 000 appels réussis.
- La facturation des appels éligibles via les outils serveur commence le 1er novembre à minuit à Pékin.
- DeepSeek recommande Harness v0.2.1-rc.1 ou une version ultérieure et a publié les poids du modèle sur Hugging Face et ModelScope.