Un petit ordinateur chinois dédié à l’IA s’attaque à un rival coûteux
Sipeed vise un prix d’environ 3 999 dollars pour un ordinateur MaixStation doté de 128 Go de mémoire et construit autour de l’AX8860P du fabricant chinois de puces Axera. La machine proposée mesure seulement 11 × 11 × 3 cm et promet d’exécuter localement de grands modèles d’IA avec une consommation typique de 40 watts. Elle entend rivaliser avec le DGX Spark de Nvidia, un système d’IA compact vendu environ 6 950 dollars dans sa version de 128 Go.
Sommaire
- Un petit ordinateur chinois dédié à l’IA s’attaque à un rival coûteux
- Ce qu’Axera a intégré dans l’AX8860P
- Pourquoi les 128 Go comptent davantage qu’un chiffre de TOPS accrocheur
- La page officielle des tests offre un aperçu plus limité
- Pourquoi les premières annonces de vitesse doivent être comparées avec prudence
- Un boîtier de poche doté de stockage standard
- Davantage de puces promettent plus de capacité, mais la montée en charge reste à démontrer
- La promesse logicielle est essentielle à l’usage quotidien
- Le prix et la livraison dépendent désormais d’une campagne
- À retenir
Axera a présenté la puce lors d’un salon industriel à Shanghai le 13 octobre 2026, date à laquelle Sipeed a également dévoilé MaixStation. La première annonce était frappante : le traitement des requêtes serait 25 % plus rapide et la génération des réponses 30 % plus rapide que sur le DGX Spark avec un modèle Qwen de 27 milliards de paramètres, pour environ la moitié du prix.
La page produit de MaixStation de Sipeed donne désormais davantage de détails. Elle annonce un débit de 592 à 677 jetons par seconde pour le traitement des requêtes avec Qwen3.8-27B et de 6 à 7 jetons par seconde pour la génération des réponses. Ces chiffres sont inférieurs aux fourchettes diffusées autour de l’annonce, tandis que le calendrier officiel prévoit une campagne Kickstarter à la fin de 2026.
L’intérêt est concret : une grande capacité mémoire dans un petit ordinateur pourrait permettre aux développeurs, aux bureaux et aux particuliers d’exécuter des modèles performants sans louer de ressources de calcul dans le cloud ni acheter plusieurs cartes graphiques. La décision d’achat dépend toutefois autant des logiciels définitifs, des performances mesurées et du calendrier de livraison que des caractéristiques de la puce.
Ce qu’Axera a intégré dans l’AX8860P
La famille AX8860 repose sur un procédé de fabrication de 6 nanomètres et associe 16 cœurs de processeur Arm Cortex-A55 à une unité de traitement neuronal dédiée, ou NPU. Une NPU est un processeur conçu pour effectuer les calculs répétitifs utilisés par les modèles d’IA. Axera et Sipeed lui attribuent une puissance maximale de 256 billions d’opérations par seconde, soit 256 TOPS, en FP4.
Le FP4 stocke les valeurs numériques avec une précision de quatre bits. L’utilisation d’un nombre réduit de bits diminue la mémoire nécessaire à un modèle et peut accélérer les calculs, à condition que le modèle et les logiciels prennent en charge ce format. Le chiffre avancé par Axera correspond à des calculs denses, et non à une mesure qui suppose que certaines valeurs peuvent être ignorées grâce à une technique appelée parcimonie.
La puce prend en charge le PCIe 5.0 et une interface mémoire de 256 bits. Sipeed indique une mémoire LPDDR5X-8533, jusqu’à 128 Go par module, ainsi qu’une bande passante de 273 Go par seconde. Son module Maix-V mesure 78 × 78 mm et utilise un connecteur LPCAMM2.
Les cœurs Cortex-A55 prennent en charge le système d’exploitation et les tâches auxiliaires, tandis que la NPU est destinée à effectuer l’essentiel des calculs liés à l’IA. Le DGX Spark de Nvidia compte 20 cœurs Arm, dont des cœurs Cortex-X925 plus puissants, tandis que les machines concurrentes AMD Ryzen AI Halo utilisent des processeurs Zen 5. Les utilisateurs qui prévoient d’associer l’inférence d’IA à d’importants calculs classiques ont donc d’autres critères à comparer que le seul accélérateur.
Pourquoi les 128 Go comptent davantage qu’un chiffre de TOPS accrocheur
Un modèle de langage a besoin de mémoire pour ses poids numériques, qui encodent ce qu’il a appris pendant son entraînement, ainsi que pour les données de travail créées lors de la réponse à une requête. Un accélérateur rapide doté d’une mémoire insuffisante peut obliger à répartir le modèle entre plusieurs appareils ou à le transférer depuis un stockage plus lent.
La configuration de MaixStation proposée avec 128 Go la place dans la même catégorie de capacité mémoire que le DGX Spark, plus imposant. Les deux affichent une bande passante de 273 Go par seconde. La gamme Ryzen AI Halo d’AMD comprend une configuration de 128 Go à environ 256 Go par seconde et une version plus coûteuse de 192 Go à 273 Go par seconde.
La capacité détermine la quantité de données qui peut tenir en mémoire. La bande passante détermine la vitesse à laquelle elles peuvent être transférées au processeur. Lors de la génération habituelle avec un modèle de langage dense, la production de chaque nouveau jeton nécessite de lire une grande quantité de données du modèle. Un jeton est une petite unité de texte, parfois un mot entier, parfois seulement une partie de mot.
Sipeed soutient donc qu’une utilisation efficace de la mémoire peut permettre à son processeur de 256 TOPS de rivaliser avec le chiffre de calcul plus élevé annoncé par Nvidia. Les quelque 1 000 TOPS en FP4 du DGX Spark tiennent compte de la parcimonie ; sa puissance en FP4 dense est d’environ 500 billions d’opérations par seconde. La vitesse réelle dans une application dépend également de l’efficacité avec laquelle les logiciels exploitent le matériel.
La page officielle des tests offre un aperçu plus limité
Sipeed distingue le préremplissage, lorsque le modèle traite la requête de l’utilisateur, du décodage, lorsqu’il génère une réponse. Un préremplissage plus rapide peut réduire le temps d’attente avant le début de la réponse, en particulier avec de longs documents. Un décodage plus rapide accélère l’affichage de la réponse une fois sa génération commencée.
Pour Qwen3.8-27B en FP4 dense, la page officielle annonce pour MaixStation un préremplissage de 592 à 677 jetons par seconde, contre 550 pour le DGX Spark. L’avance s’établit ainsi entre 8 % et 23 %. Le débit de décodage annoncé pour MaixStation est de 6 à 7 jetons par seconde, mais le texte fourni avec le graphique officiel ne donne pas de valeur de référence chiffrée pour le décodage du DGX Spark avec ce modèle.
Pour Qwen3.6-35B-A3B, un modèle à mélange d’experts, Sipeed annonce un préremplissage de 2 664 à 3 256 jetons par seconde, contre 2 368 pour le DGX Spark. L’avance calculée est d’environ 13 % à 38 %. Le débit de décodage est de 34 à 37 jetons par seconde, contre 34, soit un résultat allant de l’égalité à une avance d’environ 9 %.
Un modèle à mélange d’experts n’active qu’une partie de son réseau pour chaque jeton. Cela explique en partie pourquoi son débit de génération peut être bien supérieur à celui d’un modèle dense ayant un nombre total de paramètres similaire. Ces deux types de modèles n’effectuent pas la même quantité de calcul pour chaque jeton.
Sipeed qualifie les résultats affichés de mesures actuelles prudentes et indique que l’AX8860P est encore en cours d’optimisation. Son graphique précise que le FP4 est utilisé et que la prédiction de plusieurs jetons, ou MTP, est désactivée. La MTP est une technique qui consiste à proposer plusieurs jetons à l’avance pour accélérer la génération.
Pourquoi les premières annonces de vitesse doivent être comparées avec prudence
Les premières fourchettes de performances publiées par Sipeed étaient plus élevées : 1 400 à 1 600 jetons par seconde pour le préremplissage de Qwen3.8-27B et 15 à 17 pour le décodage, contre des valeurs de référence de 1 300 et 13 pour le DGX Spark. Pour le modèle à mélange d’experts, ces fourchettes étaient de 6 300 à 7 700 pour le préremplissage et de 80 à 88 pour le décodage, contre 5 600 et 80. Sipeed a également publié ultérieurement une comparaison plaçant MaixStation environ 10 % devant lors des deux étapes, tout en précisant que des essais plus récents montrant un écart supérieur n’étaient pas officiels.
Les valeurs absolues plus faibles de la page officielle rendent les conditions de test particulièrement importantes. La longueur des requêtes, le nombre de requêtes traitées simultanément, les formats numériques, les logiciels d’exécution et les versions des pilotes peuvent tous influer sur les résultats. Des essais indépendants du DGX Spark cités dans les articles ont atteint environ 11,5 à 11,6 jetons par seconde avec Qwen3.8-27B sans décodage spéculatif, tandis que le préremplissage variait de 840 à 1 900 selon le logiciel utilisé.
Un simple calcul de mémoire permet de comprendre l’attention portée à l’annonce initiale de 17 jetons par seconde. Si le modèle en cours d’exécution occupe environ 16 Go, diviser 273 Go par seconde par 16 Go donne environ 17 jetons par seconde, sans tenir compte des autres transferts mémoire. Pour atteindre ce débit, il faudrait exploiter la bande passante annoncée avec une efficacité exceptionnelle.
L’empreinte mémoire réelle du modèle est déterminante. Quatre bits multipliés par 27 milliards de paramètres représentent environ 13,5 Go pour les seuls poids, auxquels les données de mise à l’échelle numérique et d’autres éléments de stockage peuvent ajouter de l’espace. Des tests détaillés et reproductibles permettraient aux acheteurs de relier les chiffres de vitesse à une configuration précise du modèle.
Un boîtier de poche doté de stockage standard
Les dimensions annoncées de MaixStation correspondent à un volume de 363 centimètres cubes. Sipeed le compare aux 1 125 centimètres cubes du DGX Spark : son boîtier serait donc environ trois fois moins volumineux. L’entreprise affirme que l’appareil peut être alimenté par USB-C à l’aide d’une batterie externe adaptée, d’une puissance nominale de 65 watts.
La page officielle indique une consommation typique de 40 watts pour MaixStation et de 120 watts pour le DGX Spark. Il s’agit des consommations typiques communiquées par Sipeed. Les premières informations sur l’AX8860 évoquaient également 40 watts pour le module dédié, ce qui fait du périmètre retenu pour les mesures de puissance un autre point intéressant à vérifier lors des futurs tests.
Les connexions comprennent un réseau 10G SFP+, un port USB-C, un connecteur MCIO 8i et un emplacement M.2 2280 standard pour un SSD. Ce format de stockage offre aux acheteurs une solution familière pour ajouter de l’espace aux fichiers de modèles, qui peuvent rapidement occuper plusieurs centaines de gigaoctets.
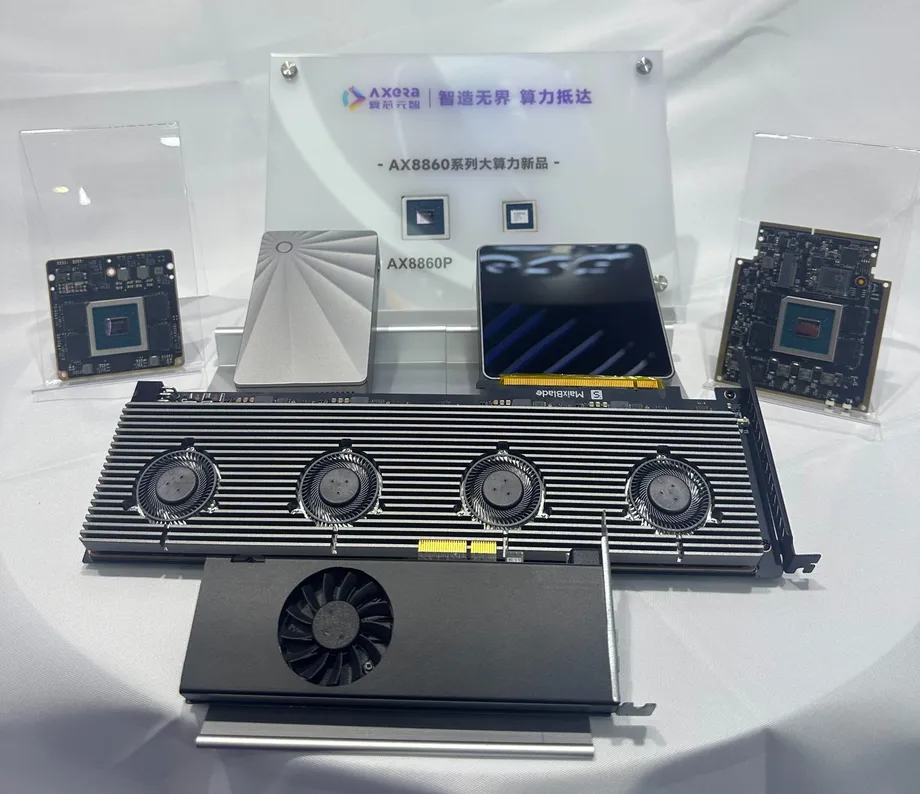
Les projets matériels d’Axera dépassent le petit ordinateur de bureau. Ils comprennent un module, une carte PCIe à une puce et une carte à quatre puces, quatre ventilateurs et un connecteur d’alimentation standard à huit broches. Sipeed associe MaixStation Pro et MaixBlade à des configurations offrant 512 Go ou plus.
Davantage de puces promettent plus de capacité, mais la montée en charge reste à démontrer
Sipeed affirme que MaixStation peut relier jusqu’à huit nœuds sans commutateur externe, grâce à une connexion entre puces annoncée à 256 gigabits par seconde et extensible à 384 gigabits par seconde. Le DGX Spark utilise une connexion de 200 gigabits pour relier les systèmes, et une configuration de quatre appareils Spark nécessite un commutateur externe.
La distinction entre gigabits et gigaoctets est importante. Une connexion annoncée à 256 gigabits par seconde correspond à un débit brut de 32 gigaoctets par seconde avant prise en compte des surcharges. La bande passante mémoire de 273 gigaoctets par seconde décrit une autre connexion, bien plus rapide, à l’intérieur de chaque machine.
Axera annonce 512 TOPS avec deux puces et 1 024 TOPS avec quatre, tout en revendiquant une efficacité de montée en charge d’environ 80 %. Le chiffre relatif à la montée en charge avec quatre puces provient d’une simulation en laboratoire. Répartir un modèle entre plusieurs processeurs entraîne aussi des échanges et des opérations de synchronisation : la vitesse dans une application dépend donc d’autres facteurs que la simple addition de leurs puissances de calcul maximales.
La feuille de route d’Axera mentionne un AX8950 pouvant atteindre 500 TOPS et un AX8970 dépassant 700 TOPS. Ces processeurs prévus offriraient des possibilités d’évolution ultérieures, mais la proposition immédiate de MaixStation repose sur l’AX8860P et ses logiciels.
La promesse logicielle est essentielle à l’usage quotidien
Sipeed annonce Debian 13 avec Linux 6.18, ainsi que la prise en charge de vLLM, SGLang, PyTorch, llama.cpp et Ollama. Ces outils permettent de charger des modèles, de traiter des requêtes et de connecter des applications d’IA au matériel. L’entreprise annonce également des API compatibles avec OpenAI et Anthropic, grâce auxquelles les applications existantes pourront envoyer des requêtes à un appareil local.
La FAQ produit de Sipeed précise que ces noms de frameworks familiers reposent sur des logiciels développés pour le matériel Axera :
SGLang et vLLM fonctionnent grâce à un backend d’accélération matérielle personnalisé, dont les kernels sont écrits en AXDSL.
Les kernels sont de petits programmes qui effectuent les calculs essentiels sur l’accélérateur. Sipeed indique que les utilisateurs peuvent charger directement les modèles Hugging Face pris en charge, tandis que les nouvelles architectures de modèles pourraient nécessiter des kernels écrits en AXDSL. L’entreprise promet de publier des kernels et des outils de développement, et affirme que l’ouverture du kit de développement logiciel de l’AX8860 est en cours.
L’entreprise annonce que des modèles et une interface accessible depuis un navigateur seront prêts dès le démarrage. Parmi les usages proposés figurent les agents de programmation, le traitement de documents, la génération vidéo et la robotique. Les cartes PCIe seront d’abord prises en charge sur des machines hôtes Linux ; la prise en charge de Windows dépendra de la demande. Lors de l’annonce, la disponibilité de la chaîne d’outils pour la NPU était prévue avant la fin octobre.
Le prix et la livraison dépendent désormais d’une campagne
Au prix prévu de 3 999 dollars, la version de MaixStation avec 128 Go coûterait environ 2 951 dollars de moins qu’un DGX Spark à 6 950 dollars, soit une baisse de 42 %. La remise est importante, sans atteindre la moitié du prix. MaixStation serait également proche du prix d’environ 3 999,99 dollars d’un AMD Ryzen AI Halo doté de 128 Go.
Le calendrier de lancement a changé par rapport aux premières prévisions, qui annonçaient l’arrivée des appareils en 2026. Les réservations sont ouvertes, mais la FAQ officielle situe la campagne Kickstarter à la fin de 2026. Sipeed prévoit une expédition dans les trois mois suivant la clôture de la campagne.
- 13 octobre 2026 : Axera présente la famille AX8860 à Shanghai et Sipeed dévoile MaixStation.
- Fin octobre 2026 : Sipeed prévoit la disponibilité de la chaîne d’outils pour la NPU.
- Fin 2026 : Sipeed prévoit sa campagne Kickstarter pour MaixStation.
- Dans les trois mois suivant la clôture de la campagne : délai d’expédition annoncé par Sipeed.
Sipeed n’a confirmé ni le prix de vente définitif, ni une date ferme de livraison, ni les performances de MaixStation vérifiées par des tests indépendants. La capacité de production, les modalités d’assistance, ainsi que le prix et le calendrier de la version Pro de 512 Go restent également à préciser. Des essais à distance et des exemplaires destinés à la presse sont prévus pendant la campagne, ce qui permettra aux acheteurs potentiels d’examiner les annonces.
À retenir
- MaixStation vise un prix d’environ 3 999 dollars avec 128 Go de mémoire et un processeur Axera AX8860P donné pour 256 TOPS en FP4 dense.
- Sipeed annonce une bande passante mémoire de 273 Go par seconde, une consommation typique de 40 watts et un boîtier de 11 × 11 × 3 cm.
- La page officielle des tests présente des débits absolus inférieurs aux premières fourchettes publiées, avec des résultats qui varient selon le modèle et l’étape de traitement.
- La prise en charge logicielle repose sur un backend d’accélération Axera personnalisé ; l’entreprise promet de publier des outils de développement et davantage de code.
- La campagne Kickstarter est prévue à la fin de 2026, avec un objectif d’expédition annoncé dans les trois mois suivant sa clôture.
- Des tests indépendants, les prix définitifs et les engagements de livraison détermineront la comparaison du système avec les solutions concurrentes de Nvidia et d’AMD.