DeepSeek occupe les deux premières places
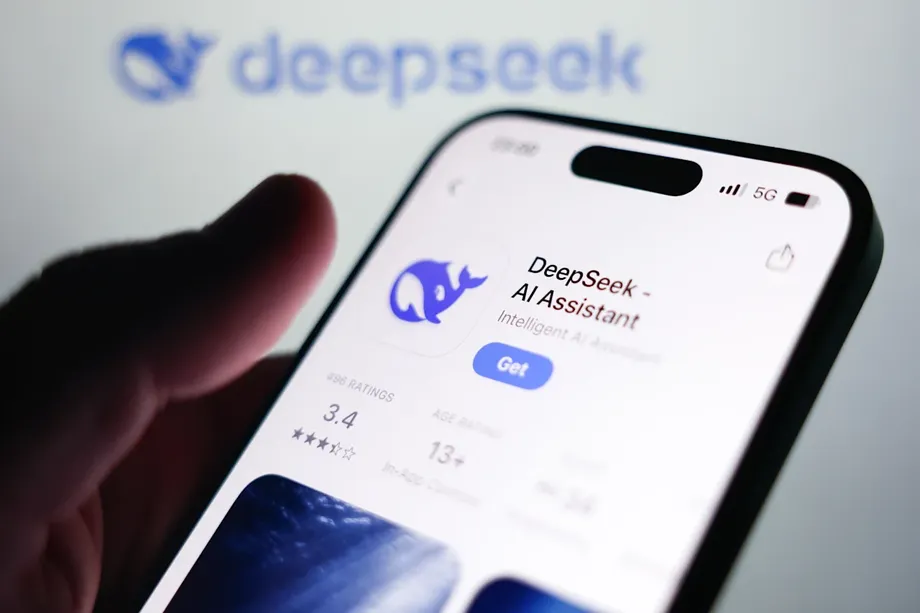
V4.1 Flash 1017 de DeepSeek a traité 35 400 milliards de jetons dans le classement hebdomadaire d’OpenRouter, devançant son prédécesseur et permettant aux développeurs chinois d’occuper les cinq premières places. Le classement de la plateforme, dont les données d’utilisation vont jusqu’au 26 octobre 2026, place DeepSeek V4.1 Flash en deuxième position avec 17 400 milliards de jetons.
Sommaire
- DeepSeek occupe les deux premières places
- Ce que mesure le classement par jetons
- Une avance chinoise renforcée, mais calculée sur un périmètre plus restreint
- DeepSeek en tête des requêtes comme des jetons
- Les lancements à l’origine du bouleversement d’octobre
- Les tableaux quotidiens et mensuels racontent des histoires différentes
- Pourquoi le codage et les agents consomment autant
- Des prix plus bas modifient l’économie des tâches répétées
- Le trafic et les dépenses suivent des tendances différentes
- À retenir
GLM 5.3 Flash de Z.ai arrive troisième avec 13 800 milliards de jetons, suivi de la version gratuite de MiniMax M3.1 Flash, avec 12 600 milliards, et de la version préliminaire Hy4 de Tencent, avec 9 000 milliards. GPT-6 Luna d’OpenAI totalise également 9 000 milliards de jetons à la précision affichée, mais se classe sixième.
Les chiffres publiés sur le classement des modèles d’IA d’OpenRouter actualisent ceux qui avaient circulé pour la période du 19 au 25 octobre. Ils attribuaient alors 33 600 milliards de jetons au dernier modèle de DeepSeek, en hausse de 801 % ; la page officielle en indique 35 400 milliards, pour une hausse de 382 %. Les chiffres précédents plaçaient également MiniMax troisième et GLM quatrième, soit dans l’ordre inverse de celui du classement officiel.
Les deux principales variantes de DeepSeek ont traité au total 52 800 milliards de jetons dans le tableau hebdomadaire officiel. À elle seule, la dernière version a traité un peu plus du double du volume de son prédécesseur, un changement notable après une mise à jour annoncée le 17 octobre.
OpenRouter permet aux développeurs d’accéder aux modèles de plusieurs entreprises par l’intermédiaire d’une interface de programmation applicative, ou API. Son classement rend compte de l’activité transitant par ce service. Le marché plus large de l’IA comprend aussi les API directes des entreprises, d’autres services cloud, les installations privées et les applications grand public.
Ce que mesure le classement par jetons
OpenRouter comptabilise à la fois les jetons de prompt, c’est-à-dire le contenu envoyé à un modèle, et les jetons de complétion, le contenu qu’il produit. Un jeton est un petit fragment de texte, qui peut correspondre à un mot ou à une partie de mot. Un long document ou une conversation prolongée peut en contenir plusieurs milliers.
Une requête est une unité différente : il s’agit d’un appel demandant à un modèle d’effectuer une tâche. Une requête peut porter sur une courte traduction, tandis qu’une autre peut inclure un vaste projet logiciel et demander des modifications approfondies. Toutes deux comptent pour une requête, mais leur nombre de jetons peut être très différent.
OpenRouter regroupe l’utilisation par journées, selon le temps universel coordonné (UTC). Son tableau hebdomadaire couvre sept jours et s’arrête au dernier intervalle complet ; le tableau mensuel couvre une période glissante de 30 jours. La date indiquée au-dessus du classement correspond à la période d’utilisation la plus récente.
Les différentes variantes d’un modèle, y compris les versions gratuites, apparaissent séparément, tandis que les requêtes marquées comme privées sont exclues. Selon le graphique, OpenRouter mesure le trafic en jetons ou en requêtes ; le nombre d’utilisateurs, les dépenses et les capacités des modèles nécessitent d’autres indicateurs.
Une avance chinoise renforcée, mais calculée sur un périmètre plus restreint
Les chiffres publiés pour la période du 19 au 25 octobre font état d’un total de 188 000 milliards de jetons traités sur OpenRouter, soit une hausse de 14,63 % par rapport à la semaine précédente. La même couverture attribuait 93 540 milliards de jetons aux modèles chinois et 22 470 milliards aux modèles américains, et faisait état de 26 semaines consécutives durant lesquelles les modèles chinois avaient traité davantage de jetons.
La ventilation détaillée précise que les totaux chinois et américains concernent l’utilisation des neuf modèles les mieux classés. Sur cette base, les modèles chinois ont traité environ 4,16 fois le volume des modèles américains, un rapport calculé en divisant 93 540 milliards par 22 470 milliards. Les modèles chinois occupaient six des neuf places.
Selon la comparaison publiée, le volume des modèles chinois a augmenté de 18,14 % et celui des modèles américains de 29,44 % par rapport à la semaine précédente. Les modèles américains ont donc progressé plus rapidement en pourcentage pendant cette période, tandis que les modèles chinois ont conservé un total de jetons nettement supérieur au sein du groupe présenté.
Ce périmètre est important pour comprendre la compétition. OpenRouter héberge des modèles provenant de plus de pays et de fournisseurs que ceux couverts par ces deux catégories nationales, et son trafic total dépasse celui des neuf premières entrées. Les 188 000 milliards de jetons correspondent à l’activité déclarée par la plateforme, et non à l’utilisation mondiale de l’IA sur l’ensemble des services.
DeepSeek en tête des requêtes comme des jetons
DeepSeek est également arrivé en tête du classement distinct d’OpenRouter sur la part des requêtes textuelles durant la semaine débutant le 19 octobre. Il en a représenté 26,5 %, devant Google à 20,1 %, OpenAI à 18,5 % et Z.ai à 10,7 %.
DeepSeek devançait Google de 6,4 points de pourcentage et OpenAI de 8 points. Google et OpenAI représentaient ensemble 38,6 % des requêtes, soit une présence importante pour ces deux développeurs américains, alors même que les modèles chinois occupaient les premières places du classement par jetons.
Anthropic représentait 5,5 % des requêtes textuelles, Qwen 4,7 %, MiniMax 2 % et Tencent 1,8 %. Mistral AI en représentait 2 % supplémentaires, tandis que l’ensemble des autres éditeurs totalisait 8,3 %.
La part des requêtes éclaire un autre aspect du marché que le volume de jetons. Un fournisseur qui traite de nombreux échanges courts peut détenir une part élevée des requêtes, tandis qu’un autre, qui gère moins de tâches mais beaucoup plus longues, peut traiter davantage de jetons. Les développeurs qui choisissent un modèle peuvent s’intéresser à la fois au nombre d’interactions et au volume de travail que chacune représente.
Les lancements à l’origine du bouleversement d’octobre
DeepSeek a annoncé V4.1 Flash 1017 le 17 octobre, dans la continuité de V4.1 Flash, lancé le 10 septembre. La mise à jour visait le raisonnement, le codage, l’automatisation et les tâches impliquant des images. L’entreprise a également rendu disponibles les poids du modèle, permettant à d’autres d’obtenir les paramètres numériques nécessaires à son exécution.
MiniMax a lancé M3.1 Flash le 19 octobre, peu avant que sa variante gratuite n’intègre le groupe de tête du classement hebdomadaire. Deux nouveaux modèles ont ainsi fait leur entrée pendant une période de forte croissance du trafic sur la plateforme.
- 10 septembre 2026 : DeepSeek lance V4.1 Flash.
- 17 octobre : DeepSeek annonce la mise à jour V4.1 Flash 1017.
- 19 octobre : MiniMax lance M3.1 Flash.
- Du 19 au 25 octobre : période couverte par les chiffres d’utilisation largement diffusés.
- 26 octobre : date des données d’utilisation les plus récentes affichées dans le classement officiel d’OpenRouter.
L’ancien V4.1 Flash de DeepSeek est resté une source majeure d’activité malgré une baisse de 41 % dans le tableau hebdomadaire officiel. La nouvelle variante a progressé de 382 %. Leur présence simultanée laisse penser que les développeurs utilisaient les deux versions pendant la transition, mais le classement ne détaille pas les décisions de changement de modèle de chaque client.
Les tableaux quotidiens et mensuels racontent des histoires différentes
DeepSeek V4.1 Flash 1017 était également en tête pour la dernière journée complète, avec 5 420 milliards de jetons traités. GLM 5.3 Flash suivait avec 2 270 milliards, talonné par l’ancien DeepSeek V4.1 Flash, à 2 210 milliards.
Le volume du modèle en tête sur la journée avait reculé de 6 % par rapport à la veille, malgré le maintien de sa première place. La version préliminaire Hy4 de Tencent a progressé de 44 %, à 1 400 milliards de jetons, et GLM 5.3 de 56 %, à 892 milliards, illustrant la rapidité avec laquelle l’activité peut se déplacer d’un modèle à un autre.
Sur les 30 derniers jours, l’ancien DeepSeek V4.1 Flash restait premier avec 123 000 milliards de jetons. GLM 5.3 Flash suivait avec 50 700 milliards. Le nouveau modèle de DeepSeek arrivait quatrième avec 42 700 milliards, derrière Space Bunny Alpha, à 46 900 milliards.
MiMo-V2.6-Flash de Xiaomi illustre la différence entre ces périodes. Il était neuvième du tableau hebdomadaire officiel avec 5 320 milliards de jetons, en baisse de 44 %, mais cinquième sur 30 jours avec 38 800 milliards, en hausse de 807 % par rapport aux 30 jours précédents. Un mois solide peut inclure une dernière semaine plus faible.
Pourquoi le codage et les agents consomment autant
MiniMax affirme que M3.1 Flash améliore les performances dans les tâches complexes réalisées par des agents, l’utilisation d’ordinateurs, le développement logiciel et la cybersécurité. L’entreprise indique également que la vitesse d’inférence en ligne a presque triplé et que les coûts d’utilisation ont baissé de 70 %. L’inférence consiste à exécuter un modèle entraîné pour générer une réponse ou effectuer une tâche.
Un agent d’IA enchaîne plusieurs actions au lieu de produire une seule réponse. Un agent de codage peut examiner des fichiers, proposer une modification, utiliser un outil, lire le résultat et retravailler son intervention. Chaque étape peut renvoyer davantage d’informations au modèle et donc accroître la consommation de jetons.
Des chiffres publiés précédemment, le 24 février, révélaient le même phénomène autour d’une génération antérieure de modèles chinois. MiniMax M2.5 arrivait en tête de ce classement hebdomadaire avec 2 450 milliards de jetons, suivi de Kimi K2.5 avec 1 210 milliards. Les modèles chinois représentaient 5 300 milliards des quelque 8 700 milliards de jetons des dix premiers modèles, soit environ 61 %.
L’utilisation hebdomadaire de MiniMax M2.5 avait bondi de 197 %, celle de GLM-5 de 158 %, tandis que celle de Kimi K2.5 avait reculé de 20 %. MiniMax avait indiqué que M2.5 avait dépassé 3 070 milliards de jetons au cours de ses sept premiers jours après son lancement. Ces chiffres couvrent des périodes différentes, mais montrent ensemble que l’adoption rapide et les brusques changements de modèle précédaient le bouleversement d’octobre.
Kimi K2.5 a été conçu pour coordonner jusqu’à 100 agents travaillant en parallèle. OpenRouter a également relevé une hausse des requêtes contenant entre 100 000 et 1 million de jetons autour de la sortie de M2.5, reliant ainsi le pic précédent aux grandes quantités de contexte utilisées dans les processus faisant intervenir des agents.
Des prix plus bas modifient l’économie des tâches répétées
Les prix publiés autour des lancements de février montrent pourquoi les développeurs, lorsqu’ils exécutent de nombreuses étapes répétées, surveillent de près les coûts. MiniMax M2.5 et GLM-5 facturaient chacun 0,30 dollar par million de jetons en entrée, contre 5 dollars pour Claude Opus 4.6, soit environ 16,7 fois plus.
Les tarifs en sortie s’élevaient à 1,10 dollar par million de jetons pour MiniMax M2.5, à 2,55 dollars pour GLM-5 et à 25 dollars pour Claude Opus 4.6. Aux tarifs affichés, la génération de 10 millions de jetons en sortie coûterait respectivement 11 dollars, 25,50 dollars ou 250 dollars, avant tout autre frais ou toute remise.
Les lancements d’octobre ont maintenu l’accent sur les coûts d’exploitation. DeepSeek appliquait des tarifs différents aux périodes de forte et de faible activité, tandis que MiniMax proposait des prix uniformes. Ces deux approches permettent aux développeurs de maîtriser les dépenses liées aux applications qui envoient régulièrement de longues conversations, des documents ou du code à un modèle.
DeepSeek a également lancé son cadre d’inférence DeepInfer, présenté comme compatible avec le matériel Nvidia et les processeurs Huawei Ascend. Sa capacité de traitement annoncée était d’environ 155 000 milliards de jetons par cluster et par jour. Ce chiffre concerne l’infrastructure qui exécute les services de modèles, un indicateur opérationnel différent du trafic acheminé par OpenRouter.
Le trafic et les dépenses suivent des tendances différentes
Le volume hebdomadaire de jetons déclaré par OpenRouter est passé de 5 510 milliards fin octobre 2025 à 188 000 milliards fin octobre 2026. Le rapport entre les deux chiffres est d’environ 34, ce qui illustre l’expansion rapide de la charge de travail de la plateforme.
Les dépenses par type de tâche rendent compte d’un autre aspect de cette croissance. Les tâches générales représentaient 32,1 %, les processus faisant intervenir des agents 30,9 % et le codage 26,7 %. Ces trois catégories totalisaient ainsi 89,7 % des dépenses présentées dans cette ventilation.
Claude Opus 5.5 arrivait en tête du classement des dépenses de classification, avec 10,3 %. La classification consiste à attribuer une étiquette ou une catégorie, par exemple pour identifier la demande d’un client, étiqueter un document ou décider à quel processus transmettre un message.
La facture des développeurs dépend autant des prix que du nombre de jetons. Un modèle moins cher peut traiter un volume bien plus important tout en générant moins de revenus par jeton. La rentabilité dépend alors du coût du calcul, de l’exploitation du service et de la fourniture du service aux clients payants. Les chiffres ne précisent pas les revenus ni les bénéfices des fournisseurs pour cette période.
Le déploiement de l’IA chinoise ne se limite pas aux modèles de langage généralistes. Les services météorologiques de plus de 40 pays ont utilisé le modèle d’alerte météo MAZU par l’intermédiaire de services cloud, et des versions personnalisées ont été déployées dans sept pays, dont le Pakistan, l’Éthiopie et les îles Salomon. Ces applications spécialisées illustrent une autre manière dont les modèles atteignent leurs utilisateurs, en dehors des classements d’API publiques.
À retenir
- DeepSeek V4.1 Flash 1017 est en tête du tableau hebdomadaire officiel d’OpenRouter avec 35 400 milliards de jetons, devant V4.1 Flash et ses 17 400 milliards.
- Les développeurs chinois occupent les cinq premières places : GLM 5.3 Flash est troisième, la variante gratuite de MiniMax M3.1 Flash quatrième et la version préliminaire Hy4 cinquième.
- DeepSeek représente 26,5 % des requêtes textuelles durant la semaine débutant le 19 octobre, devant Google et OpenAI.
- Les 26 semaines d’avance chinoise annoncées concernent l’utilisation d’OpenRouter ; les totaux nationaux détaillés cités pour la période du 19 au 25 octobre couvrent les neuf premiers modèles.
- Le codage, les processus faisant intervenir des agents et la baisse des prix contribuent à expliquer la croissance des interactions répétées et longues avec les modèles.
- Les classements d’OpenRouter mesurent le trafic de la plateforme ; les dépenses, les capacités des modèles et les bénéfices des fournisseurs reposent sur d’autres indicateurs.