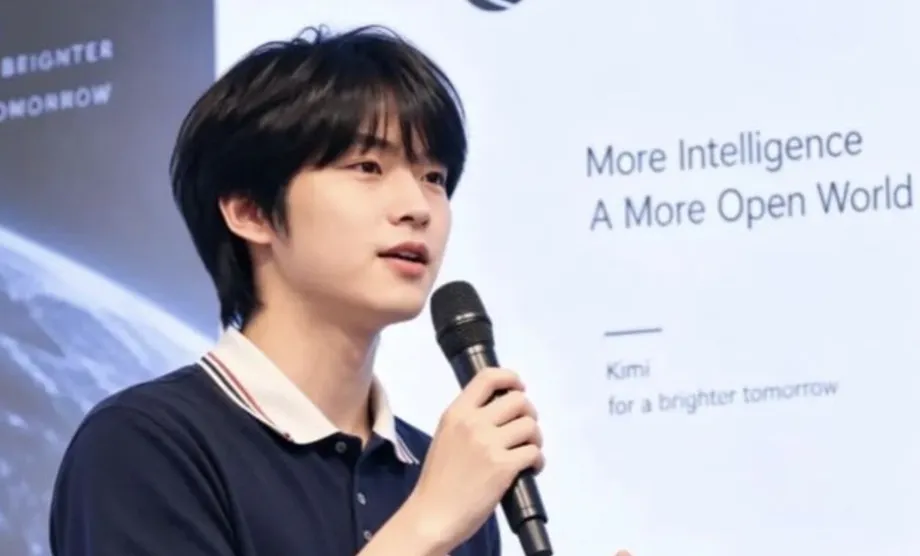
Un chercheur adolescent quitte Moonshot après avoir contribué à la refonte de Kimi
Chen Guangyu, chercheur de 17 ans qui a contribué à mettre au point une nouvelle façon pour les modèles d’intelligence artificielle de transmettre des informations entre leurs couches, a annoncé le 15 octobre 2026 qu’il quittait Moonshot AI, l’entreprise chinoise à l’origine de Kimi. Il avait rejoint son équipe de recherche en novembre 2025, à l’âge de 16 ans.
Sommaire
- Un chercheur adolescent quitte Moonshot après avoir contribué à la refonte de Kimi
- La contribution de Chen aux travaux de recherche
- Comment Attention Residuals modifie un modèle
- Ce que montrent les résultats publiés
- D’un hackathon scolaire à une équipe de recherche
- Les dates d’une ascension rapide
- L’invitation d’Anthropic et l’histoire du million de dollars
- Pourquoi Discovery Loop est entrée dans la discussion
- Ce que son départ laisse derrière lui chez Moonshot
- Points clés
Connu à l’international sous le nom de Nathan Chen, l’adolescent de Shenzhen part avec une contribution concrète à la recherche : il est coauteur principal à égalité d’Attention Residuals, un article publié le 16 mars 2026 avec les chercheurs de Moonshot Yu Zhang et Jianlin Su. Selon les comptes rendus de la sortie du modèle en juillet, cette technique a ensuite été intégrée à Kimi K3.
Les expériences publiées par Moonshot donnent une image plus précise de ces travaux que l’attention suscitée par son âge. Lors de tests sur un modèle Kimi Linear de 48 milliards de paramètres, les chercheurs ont enregistré des progrès pour toutes les tâches évaluées. Leur méthode Block Attention Residuals a également égalé la perte d’entraînement d’un modèle classique doté de 1,25 fois plus de puissance de calcul.
Le départ de Chen a suscité une invitation publique d’Anthropic, des spéculations sur une start-up fondée par d’anciens chercheurs de Google et des tentatives de l’associer à un adolescent non identifié qui aurait reçu cinq offres d’emploi d’une valeur d’environ un million de dollars chacune, voire davantage.
Chen a toutefois publiquement rejeté l’idée qu’il rejoindrait Anthropic. Son prochain employeur, une éventuelle rémunération et la possibilité qu’il reprenne des études universitaires n’ont pas été confirmés.
Dans son message d’adieu, Chen a évoqué son passage chez Moonshot et remercié les personnes qui l’avaient recruté. Le stagiaire en recherche sur l’apprentissage automatique, sur le départ, a déclaré :
L’année écoulée a été la meilleure de ma vie.
Son message s’est achevé sur son désir de continuer à explorer, sans mentionner de destination précise.
La contribution de Chen aux travaux de recherche
Le nom de Chen apparaît avec ceux de Zhang et Su, avec la mention d’une contribution égale, dans le rapport de l’équipe Kimi sur Attention Residuals. Cette mention reconnaît à tous trois un rôle majeur dans un travail collectif de plus grande ampleur.
Su, connu pour ses travaux sur les représentations positionnelles rotatives, ou RoPE, a mené les expériences initiales. RoPE aide un modèle de langage à repérer la position des mots ou d’autres éléments d’information dans une séquence. Zhang était le premier auteur des travaux de recherche sur l’architecture Kimi Linear.
Su a attribué à Zhang et Chen le mérite d’avoir transformé l’idée initiale d’Attention Residuals en une méthode concrètement applicable aux grands modèles. Ensemble, ils ont proposé Block AttnRes, une version conçue pour préserver les avantages de la méthode tout en réduisant les besoins en mémoire et en communication lors de son application à grande échelle.
Chen a également travaillé à l’accélération des noyaux de calcul de Kimi Delta Attention, ou KDA. Un noyau est un petit programme qui exécute un calcul particulier sur un processeur graphique. L’améliorer peut permettre au même matériel d’effectuer une tâche plus rapidement.
Ses travaux ont donc couvert deux domaines liés : déterminer la conception d’un modèle et optimiser l’exécution des calculs qui la sous-tendent. Pour un laboratoire qui entraîne de grands modèles, ces deux aspects déterminent la quantité de recherche qu’il peut mener avec son budget de calcul.
Comment Attention Residuals modifie un modèle
Les modèles de langage traitent les informations au moyen de nombreuses couches successives. Chaque couche transforme les informations qu’elle reçoit et construit des représentations utilisées par les couches suivantes pour prédire une réponse.
Les connexions résiduelles classiques permettent aux informations antérieures de circuler dans ce processus en additionnant les sorties des couches. Le dépôt de recherche officiel de Moonshot décrit un problème lié à cette approche : à mesure que le modèle s’approfondit, les accumulations successives peuvent diluer les contributions individuelles et faire croître l’amplitude des signaux internes.
Attention Residuals remplace cette accumulation fixe par un mécanisme de sélection appris. Une couche ultérieure peut attribuer des pondérations différentes aux informations produites plus tôt, en fonction de l’entrée actuelle. On peut comparer cela à un lecteur qui consulte les notes les plus utiles des chapitres précédents plutôt que de conserver toutes les notes avec la même importance.
Appliquer ce mécanisme de sélection séparément à chacune des couches précédentes entraîne de nouveaux coûts. Block AttnRes regroupe les couches, conserve les additions habituelles au sein de chaque groupe et sélectionne parmi les représentations obtenues. Selon le dépôt, environ huit groupes permettent de récupérer la majeure partie des gains de la méthode complète.
La configuration Kimi Linear la plus importante décrite dans l’article comptait 54 couches, regroupées par six. Ses neuf groupes, auxquels s’ajoute la représentation initiale des jetons, fournissaient 10 sources d’information parmi lesquelles effectuer une sélection. Cette étape d’ingénierie pratique a contribué à faire passer l’idée de l’expérimentation à l’entraînement de grands modèles.
Ce que montrent les résultats publiés
L’article de mars a testé Attention Residuals dans un modèle Kimi Linear comptant 48 milliards de paramètres au total, dont 3 milliards étaient activés pendant le traitement. Les paramètres sont les valeurs numériques apprises à l’intérieur d’un modèle. N’en activer qu’une partie permet au modèle de puiser dans un vaste ensemble de connaissances apprises tout en limitant les calculs nécessaires à chaque étape.
L’entraînement a utilisé 1 400 milliards de jetons, c’est-à-dire les éléments de texte ou d’autres données traités par un modèle. Les chercheurs ont conservé les autres principaux composants architecturaux du modèle, ce qui leur a permis de comparer l’ajout d’Attention Residuals à la conception de référence.
Sur GPQA-Diamond, un test portant sur des questions scientifiques difficiles, le score est passé de 36,9 à 44,4, soit une hausse de 7,5 points. HumanEval, qui évalue la génération de code, est passé de 59,1 à 62,2. MMLU, un vaste test de connaissances, est passé de 73,5 à 74,6.
La comparaison des besoins en calcul est également utile. Égaler un modèle de référence qui utilise 1,25 fois plus de calcul revient à atteindre la même perte d’entraînement publiée avec quatre cinquièmes de son budget, soit 20 % de calcul en moins. La perte d’entraînement mesure l’écart entre les prédictions du modèle et les réponses attendues pendant l’entraînement.
Moonshot a indiqué séparément que cette technologie avait contribué à une amélioration d’environ 25 % de l’efficacité de l’entraînement de K3, pour moins de 2 % de surcoût. Les expériences de mars et les déclarations ultérieures concernant K3 portent sur des configurations de modèles différentes ; les résultats détaillés des tests présentés ci-dessus proviennent de Kimi Linear.
D’un hackathon scolaire à une équipe de recherche
Chen est né à Shenzhen en 2009. Avant de rejoindre Moonshot, il a organisé une communauté d’adolescents autour de l’open source, développé des robots logiciels et exploré des sujets allant de la sécurité de l’IA à la physique.
Pendant la préparation de ses candidatures universitaires, il a mis en pause certaines activités qui ne lui plaisaient pas et s’est mis à lire sur des sujets qui l’intéressaient. Son parcours vers la recherche a ensuite combiné apprentissage autonome, publications techniques en ligne et échanges avec des chercheurs en activité.
En février 2025, il a participé à un hackathon de Moonshot AI destiné aux élèves du secondaire, avec ThirdArm, un projet imaginant un bras robotique supplémentaire pour aider les personnes. Il y a rencontré Dong Kehan, membre de l’équipe fondatrice de MiraclePlus, qui l’a encouragé à se concentrer sur les technologies de pointe.
Une publication technique sur DeltaNet lui a ensuite valu une réponse du chercheur Songlin Yang. La discussion est parvenue à Ben Keigwin, de Tilde Research, une start-up de Palo Alto, en Californie, et a débouché sur un échange au sujet de ses travaux. En juillet 2025, Chen s’y est rendu seul, à l’âge de 16 ans, pour un stage de sept semaines.
Pour apprendre, Chen a notamment passé des heures à discuter d’articles scientifiques avec Gemini, à envoyer des captures d’écran de passages difficiles et à poser des questions complémentaires. Il a aussi lu du code, des blogs et les sites de chercheurs, et demandé conseil à Yuan Jingyang, chercheur chez DeepSeek, pour prendre des décisions importantes.
Son expérience ne se résume pas à l’utilisation d’un chatbot comme tuteur. Ses publications ont rendu visible son raisonnement technique, des chercheurs y ont réagi et des stages lui ont donné l’occasion de mettre ses idées en pratique dans un cadre collaboratif.
Les dates d’une ascension rapide
En moins de deux ans, Chen est passé d’un projet scolaire à un stage à l’étranger, puis à la publication de travaux sur des modèles. Son départ est survenu après l’intégration d’Attention Residuals dans une version majeure de Kimi.
- Février 2025 : Chen participe au hackathon d’IA de Moonshot destiné aux élèves du secondaire.
- Juillet 2025 : Il commence un stage de sept semaines chez Tilde Research, à Palo Alto.
- Novembre 2025 : Il rejoint l’équipe Kimi de Moonshot comme stagiaire en recherche sur l’apprentissage automatique, à l’âge de 16 ans.
- 16 mars 2026 : Le rapport technique sur Attention Residuals est publié ; Chen, Zhang et Su y sont crédités à égalité.
- Juin 2026 : Chen obtient son diplôme de fin d’études secondaires.
- Juillet 2026 : Kimi K3 est lancé avec Attention Residuals parmi ses technologies architecturales.
- 15 octobre 2026 : Chen annonce son départ de Moonshot.
- 16 octobre 2026 : Il rejette les spéculations selon lesquelles il rejoindrait Anthropic.
- 20 octobre 2026 : Un compte anonyme affirme qu’il rejoint Discovery Loop.
Son parcours scolaire public mentionne également une inscription à l’université Carnegie Mellon en août et septembre 2026. Cette brève mention alimente les spéculations sur la possibilité qu’il reprenne des études ou qu’il entre dans la vie professionnelle.
L’invitation d’Anthropic et l’histoire du million de dollars
Sholto Douglas, qui dirige la recherche sur l’apprentissage par renforcement à grande échelle chez Anthropic, a commenté le message d’adieu de Chen. Il lui a demandé s’il comptait toujours étudier à Carnegie Mellon et l’a invité à travailler avec lui à San Francisco.
Chen a répondu qu’il se rendait dans la région de la baie de San Francisco. Lorsque cet échange a suscité des suggestions selon lesquelles il aurait rejoint Anthropic, il les a brièvement rejetées :
non :)
La discussion sur les salaires a commencé séparément. Deedy Das, investisseur chez Menlo Ventures, a raconté avoir rencontré un adolescent de 17 ans non identifié, qui avait appris l’IA en autodidacte avec l’aide de modèles de langage, effectué environ un an de stage dans une entreprise d’IA de premier plan et quitté au bout de deux semaines un programme de premier cycle dans une université américaine très réputée.
Selon Das, cet adolescent avait reçu cinq offres de laboratoires d’IA de premier plan à San Francisco, chacune d’une valeur d’environ un million de dollars ou plus. Das a également rapporté que l’adolescent préférait apprendre plutôt que gagner de l’argent.
Sur les réseaux sociaux, des internautes ont rapproché cette description de Chen en raison de son âge et de son parcours de recherche. Das n’a pas nommé l’adolescent, et Chen n’a pas confirmé que ces offres lui étaient destinées. La discussion porte donc sur des offres rapportées concernant une personne non identifiée, et non sur un contrat de travail divulgué pour Chen.
L’invitation publique de Douglas constitue un signe d’intérêt plus concret : un chercheur de haut niveau a ouvertement encouragé Chen à le rejoindre. Le démenti qui a suivi apporte aussi une réponse directe aux spéculations concernant Anthropic.
Pourquoi Discovery Loop est entrée dans la discussion
Discovery Loop est devenue le nouveau centre des spéculations après qu’Arfur Grok, un compte anonyme qui suit les mouvements de personnel dans le secteur de l’IA, a affirmé le 20 octobre que Chen avait rejoint l’entreprise. Chen n’a pas confirmé son arrivée et la start-up a refusé de commenter les questions liées à son personnel.
L’entreprise a été fondée en août 2026 par les anciens chercheurs de Google Jeff Dean, Sanjay Ghemawat, Quoc Le et Oriol Vinyals. Elle dit vouloir utiliser l’IA pour automatiser la recherche scientifique et l’apprentissage automatique, notamment en proposant des idées, en menant des expériences et en analysant les résultats.
Pour un chercheur qui s’intéresse à la conception de modèles efficaces, cette mission recouperait des problèmes techniques familiers. Les systèmes qui exécutent de nombreuses expériences de recherche doivent utiliser efficacement les ressources informatiques, et des améliorations d’algorithmes ou de noyaux de calcul peuvent permettre de mener davantage d’expériences avec un budget fixe.
Le financement de Discovery Loop a lui aussi attiré l’attention. En septembre, l’entreprise aurait cherché à lever des fonds sur la base d’une valorisation d’environ 50 milliards de dollars, contre des discussions autour de 10 milliards quelques semaines plus tôt, soit une multiplication par cinq. Ces chiffres correspondent à des valorisations envisagées lors de discussions de financement.
Chen a également déjà des liens avec la région de la baie de San Francisco grâce à Tilde Research. Son précédent stage là-bas aide à comprendre qu’un déplacement en Californie pourrait lui permettre de rencontrer plusieurs contacts professionnels, sans forcément avoir une destination unique et évidente.
Ce que son départ laisse derrière lui chez Moonshot
Du Yulun, chercheur chez Moonshot qui a soutenu le recrutement de Chen à 16 ans, a déclaré qu’ils avaient eu plusieurs longues conversations au sujet de sa décision de partir. Il a exprimé sa tristesse tout en soutenant le souhait de Chen d’explorer de nouveaux centres d’intérêt à son âge.
Les contributions de Chen restent inscrites dans les travaux de l’équipe. Kimi K3, lancé en juillet avec 2 800 milliards de paramètres, associe Attention Residuals à Kimi Delta Attention. Ces deux technologies portent sur des aspects différents du traitement de l’information : AttnRes modifie la circulation de l’information dans la profondeur du modèle, tandis que KDA permet de traiter efficacement les séquences.
Moonshot a attribué à l’ensemble des changements architecturaux, des méthodes d’entraînement et des choix de données une amélioration d’environ 2,5 fois de l’efficacité de mise à l’échelle de K3 par rapport à K2. Les travaux de Chen s’inscrivent donc dans un effort plus large de l’entreprise, auquel participent de nombreux chercheurs et qui comprend plusieurs changements techniques.
Les enjeux pratiques dépassent la carrière d’un employé exceptionnellement jeune. Un modèle qui apprend plus efficacement peut mieux tirer parti de processeurs coûteux et des budgets de recherche. Un chercheur capable de relier conception mathématique et mise en œuvre rapide peut contribuer directement à cet objectif.
Chen quitte Moonshot avec des travaux publiés, une expérience dans deux environnements de recherche et l’intérêt public d’un autre laboratoire de premier plan. Les faits confirmés sont déjà remarquables : un adolescent a contribué à transformer une idée architecturale en une méthode opérationnelle, puis a choisi de poursuivre ses explorations avant d’annoncer son prochain poste.
Points clés
- Chen Guangyu, également connu sous le nom de Nathan Chen, a annoncé son départ de Moonshot AI le 15 octobre 2026, à l’âge de 17 ans.
- Il a partagé à égalité le statut de premier auteur avec Yu Zhang et Jianlin Su pour Attention Residuals, publié le 16 mars.
- Les expériences de Moonshot ont montré des progrès pour toutes les tâches évaluées et égalé les résultats d’un modèle de référence utilisant 1,25 fois plus de calcul.
- Chen a contribué à l’élaboration de Block AttnRes et travaillé à l’accélération des calculs de Kimi Delta Attention.
- Il a indiqué qu’il se rendait dans la région de la baie de San Francisco et rejeté les spéculations selon lesquelles il rejoindrait Anthropic.
- Son arrivée présumée chez Discovery Loop et les spéculations l’associant à cinq offres d’environ un million de dollars chacune restent non confirmées.