Un modèle qui apprend les lettres de l’ARN et leurs liens
Des chercheurs de l’Université des sciences et technologies de Chine ont publié structRFM, un modèle de fondation ouvert pour l’ARN, entraîné sur 21 millions de paires de séquences d’ARN et de structures annotées par calcul. Cette publication comprend les données d’entraînement appariées, les poids du modèle et le code source, fournissant ainsi à d’autres laboratoires les ressources nécessaires pour reproduire les travaux et adapter le système.
Sommaire
- Un modèle qui apprend les lettres de l’ARN et leurs liens
- Pourquoi le repliement compte autant que la séquence
- Comment les 21 millions de paires d’entraînement ont été constituées
- Enseigner au modèle à partir d’informations masquées
- Résultats des tests de prédiction des structures
- Du traitement de l’ARN à sa classification fonctionnelle
- Ce que la publication ouverte met à la disposition des chercheurs
- L’équipe et le calendrier de publication
- Ce que les résultats changent pour la recherche sur l’ARN
- Points clés
L’étude, publiée par Nature le 4 novembre 2026, décrit un modèle qui apprend à la fois l’ordre des éléments constitutifs moléculaires de l’ARN et les liens qui contribuent au repliement de ces molécules. Son adaptation à la prédiction de structures tridimensionnelles, baptisée Zfold, a obtenu des résultats que les auteurs jugent comparables à ceux d’AlphaFold3 lors des évaluations CASP15-natural, CASP16 et RNA-Puzzles.
L’intérêt pratique de structRFM tient au fait qu’après son entraînement, il ne nécessite qu’une séquence d’ARN en entrée. Il produit des informations que les chercheurs peuvent exploiter pour plusieurs tâches, notamment la prédiction de structures moléculaires, l’identification de sites impliqués dans le traitement de l’ARN et la classification des molécules d’ARN selon leur fonction.
L’article de recherche sur structRFM publié par Nature présente ces travaux comme un moyen de rendre les connaissances structurelles utiles à différentes tâches de prédiction. Peng Xiong et S. Kevin Zhou sont les auteurs correspondants, et Heqin Zhu est le premier auteur.
Pourquoi le repliement compte autant que la séquence
L’ARN intervient dans la production des protéines, la régulation des gènes et le traitement des messages génétiques. Sa séquence correspond à l’ordre de ses nucléotides, les unités moléculaires généralement représentées par les lettres A, U, C et G. Cet ordre porte une information, tandis que le repliement de la molécule contribue à déterminer son fonctionnement.
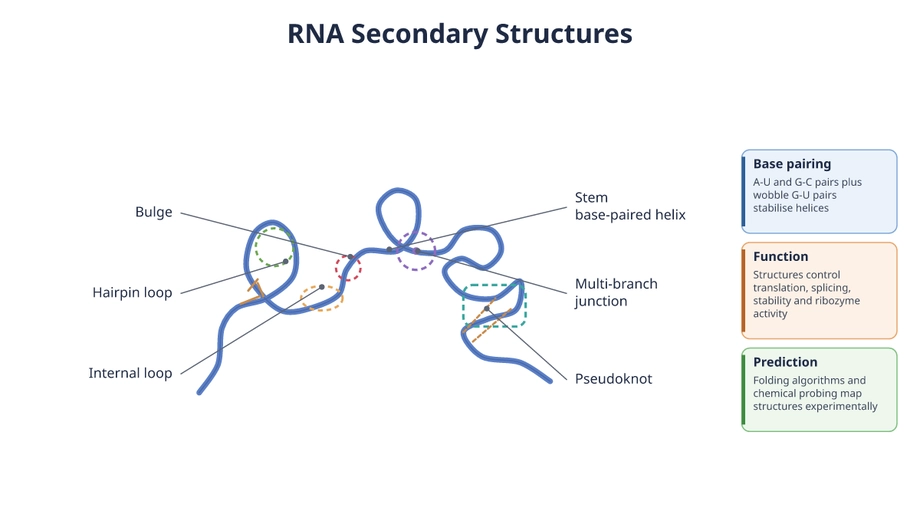
Des parties d’un brin d’ARN peuvent s’apparier avec d’autres parties du même brin. Ces liens forment une structure secondaire, un agencement de régions appariées, de tiges et de boucles. La molécule se replie ensuite en une forme tridimensionnelle, appelée structure tertiaire, qui influe sur son activité et ses interactions avec d’autres molécules.
De nombreux modèles de langage pour l’ARN apprennent des régularités à partir de vastes collections de séquences, comme un modèle de langage apprend les relations entre les mots. structRFM intègre pendant l’entraînement des informations sur les nucléotides qui s’apparient, ce qui l’aide à apprendre les liens entre des positions parfois très éloignées dans la séquence.
Les chercheurs ont voulu préserver la souplesse d’un modèle de fondation : un système entraîné de manière générale, dont les caractéristiques acquises peuvent être adaptées à différents usages. Leur objectif était d’intégrer les informations sur le repliement à cette base commune, plutôt que d’entraîner un système utile à une seule tâche structurelle.
Comment les 21 millions de paires d’entraînement ont été constituées
L’équipe a constitué un jeu de données d’environ 21 millions de paires associant séquences d’ARN et structures secondaires. Les annotations structurelles ont été générées par calcul, ce qui a permis aux chercheurs d’entraîner le modèle à une échelle bien supérieure à celle d’une collection composée uniquement de structures déterminées par des expériences en laboratoire.
Les prédictions informatiques peuvent comporter des erreurs et refléter les points forts et les limites de la méthode utilisée. Pour limiter la dépendance à un prédicteur unique, les chercheurs ont mis au point MUSES, un ensemble de structures secondaires fondé sur plusieurs sources. Un tel ensemble combine des informations issues de plusieurs sources de prédiction au lieu de s’appuyer entièrement sur une seule.
MUSES s’attaque à un problème central de l’entraînement des modèles à partir de structures prédites : des erreurs répétées dans les annotations d’entraînement peuvent façonner ce que le modèle apprend. Le regroupement de prédictions structurelles visait à réduire le biais lié aux prédicteurs tout en conservant des informations utiles sur l’appariement des bases.
Les ressources d’entraînement et d’évaluation de l’étude s’appuient sur des collections biologiques de référence, notamment RNAcentral, Rfam et la Protein Data Bank. La déclaration relative aux données précise les versions utilisées, dont RNAcentral 24.0 et Rfam 14.10 et 15.0, afin que les chercheurs puissent retrouver les jeux de données employés dans les expériences.
Enseigner au modèle à partir d’informations masquées
structRFM utilise la modélisation du langage masqué, une méthode d’entraînement dans laquelle certaines parties d’une entrée sont cachées et le modèle apprend à retrouver les informations manquantes à partir du contexte. Pour l’ARN, il s’agit d’apprendre les relations entre les nucléotides plutôt qu’entre les mots.
L’équipe a intégré l’appariement des bases à ce processus grâce à une opération d’appariement des paires. Un taux de masquage dynamique équilibre l’entraînement guidé par les liens structurels et le masquage de positions nucléotidiques individuelles. Le modèle peut ainsi apprendre à la fois des régularités locales de séquence et des relations liées au repliement.
Le modèle produit trois types de caractéristiques : des informations sur la séquence dans son ensemble, des informations sur chaque nucléotide et des informations sur les paires de nucléotides. Une caractéristique est une représentation numérique qu’un autre système de prédiction peut exploiter. Différentes tâches peuvent s’appuyer sur différents niveaux de cette représentation.
Les chercheurs ont également mené des expériences d’ablation, qui consistent à supprimer ou modifier des parties d’un modèle pour évaluer leur contribution. Ces expériences ont confirmé l’apport des informations structurelles et de la stratégie de masquage aux améliorations rapportées, étayant ainsi les choix de conception de structRFM.
Résultats des tests de prédiction des structures
structRFM a obtenu de très bons résultats en classification de l’homologie sans entraînement spécifique. L’homologie désigne les liens hérités d’une origine évolutive commune. Dans ce contexte, la classification sans entraînement spécifique évalue l’utilité des représentations apprises pour reconnaître de tels liens sans entraîner le modèle spécifiquement à la tâche de classification visée.
Les auteurs font également état d’une amélioration de la prédiction des structures secondaires et de bons résultats sur des familles d’ARN nouvellement publiées. Une famille d’ARN regroupe des molécules apparentées qui partagent des caractéristiques de séquence ou de structure. L’évaluation sur de nouvelles familles permet de mesurer les performances du modèle au-delà des groupes déjà représentés dans les bases de données établies.
Pour la prédiction des structures tertiaires, l’équipe a développé Zfold en adaptant les caractéristiques apprises par structRFM à un modèle qui prédit des formes tridimensionnelles. Les auteurs font état d’améliorations tant pour les formes prédites que pour les structures secondaires extraites de ces prédictions.
Zfold a été évalué sur CASP15-natural, CASP16 et RNA-Puzzles, des collections de référence utilisées pour mesurer les performances en prédiction de structures moléculaires. Dans l’ensemble de ces évaluations, l’article juge ses performances comparables à celles d’AlphaFold3. Cette comparaison porte sur les résultats de Zfold dans ces évaluations précises, structRFM fournissant les représentations sous-jacentes de l’ARN.
L’étude fait état de plusieurs types de réussite, plutôt que d’un score de précision unique couvrant tous les usages. Reconnaître des séquences apparentées, prédire des paires de bases et reconstruire une forme tridimensionnelle sont des problèmes distincts, qui nécessitent chacun une évaluation propre.
Du traitement de l’ARN à sa classification fonctionnelle
structRFM a également été testé sur des tâches portant sur le rôle de l’ARN. Elles comprenaient la prédiction des sites d’épissage, l’identification des sites d’entrée internes des ribosomes et la classification des ARN non codants, élargissant ainsi l’évaluation au-delà de la forme moléculaire.
Les sites d’épissage marquent les limites utilisées par les cellules lors du traitement des messages d’ARN. Pendant l’épissage, certaines parties sont retirées et les segments restants sont assemblés. La prédiction de ces limites aide les chercheurs à étudier la façon dont un message génétique est assemblé avant de servir à produire une protéine.
Les sites d’entrée internes des ribosomes, ou éléments IRES, sont des régions d’ARN qui permettent à la machinerie cellulaire responsable de la production des protéines d’initier la traduction en interne. Les identifier exige de reconnaître des motifs fonctionnels dans une séquence, ce qui en fait un autre test des informations acquises pendant le préentraînement.
Les ARN non codants remplissent des fonctions autres que celle de servir de matrice à la production de protéines. Les classifier consiste à attribuer les molécules aux groupes pertinents. Les auteurs font état de meilleures performances pour l’ensemble de ces tâches fonctionnelles, montrant que les représentations apprises restent utiles lorsque la cible de prédiction passe de la structure au rôle biologique.
L’équipe a également étendu le modèle à la classification des longs ARN non codants à l’aide d’une stratégie de segmentation. Diviser une longue séquence en sections permet d’appliquer le modèle à des entrées qui seraient autrement difficiles à traiter en un seul bloc.
Ce que la publication ouverte met à la disposition des chercheurs
La publication comprend trois ressources aux usages différents. Le jeu de données fournit les exemples utilisés pour l’apprentissage. Les poids du modèle contiennent les valeurs numériques acquises pendant l’entraînement. Le code source décrit l’implémentation et l’exécution du logiciel.
L’accès aux poids permet aux chercheurs d’utiliser un modèle déjà entraîné, sans devoir répéter l’ensemble du préentraînement. L’accès aux données et au code facilite l’examen approfondi de la procédure d’entraînement, la reproduction des expériences et le développement d’autres approches.
L’article indique que le dépôt du projet est heqin-zhu/structRFM sur GitHub. Il répertorie également une archive Zenodo du jeu de données de préentraînement sous le DOI 10.5281/zenodo.18272040, ainsi qu’une archive du code source et des points de contrôle du modèle sous le DOI 10.5281/zenodo.18274292. Un DOI est un identifiant pérenne destiné à assurer la traçabilité d’une ressource de recherche au fil du temps.
La déclaration relative aux données indique que les jeux de données d’entraînement et de test sont accessibles au public via le dépôt du projet. Elle fournit également le sous-ensemble IRES traité utilisé dans l’étude, ainsi que les données sources à l’origine des figures. Les auteurs précisent qu’aucune restriction ne s’applique à la disponibilité des données.
Ces précisions sont importantes pour les comparaisons. Les chercheurs peuvent examiner les jeux de données et les partitions utilisés, relancer les évaluations et vérifier si un autre choix d’entraînement modifie les résultats. La publication favorise ainsi l’examen des conclusions autant que la réutilisation du modèle.
L’équipe et le calendrier de publication
Les travaux ont été menés au sein de l’École de génie biomédical de l’USTC et du laboratoire d’imagerie médicale, de robotique, de calcul analytique et d’apprentissage, connu sous le nom de MIRACLE. Les auteurs indiquent des affiliations à Hefei et à l’Institut de recherche avancée de Suzhou de l’USTC. Le coauteur Ruifeng Li est affilié au Collège d’informatique et de technologie de l’Université du Zhejiang, à Hangzhou.
Zhou, professeur, et Xiong, chercheur associé, ont conçu et supervisé l’étude. Zhu a conçu et mis en œuvre le cadre, mené le préentraînement ainsi que plusieurs expériences de prédiction de structures et de classification de l’ARN, et analysé les résultats. D’autres membres de l’équipe ont travaillé sur les tests d’homologie, les comparaisons de jeux de données, l’identification des IRES et l’évaluation structurelle.
La publication et la présentation publique de ces travaux se répartissent sur deux dates calendaires :
- 4 novembre 2026 : Nature indique la publication de l’article « An open structure-guided RNA foundation model for generalizable prediction ».
- 5 novembre 2026 : Les travaux et leur publication en libre accès ont été annoncés en Chine ; la publication en ligne est décrite comme ayant eu lieu tôt le matin.
Les auteurs indiquent avoir bénéficié du soutien de la Fondation nationale des sciences naturelles de Chine, du Programme national clé de recherche et développement, de programmes de recherche menés au Jiangsu et à Suzhou, ainsi que du projet Sanming de médecine à Shenzhen. Ils déclarent n’avoir aucun conflit d’intérêts.
Ce que les résultats changent pour la recherche sur l’ARN
structRFM fournit un point de départ commun à plusieurs activités de recherche. Un laboratoire qui étudie le traitement de l’ARN peut adapter le même modèle de base qu’un autre groupe utilise pour étudier le repliement ou classer des molécules non codantes. Chaque application nécessite toutefois un développement et une évaluation spécifiques.
La combinaison de 21 millions de paires d’entraînement, de l’apprentissage guidé par la structure et de points de contrôle publiés donne aux chercheurs un système concret à examiner, plutôt qu’une simple description d’algorithme. MUSES et les expériences de masquage proposent aussi des choix de conception précis que d’autres équipes peuvent tester ou modifier.
Les résultats présentés portent sur la prédiction et la classification informatiques. Les travaux visant des applications biomédicales nécessiteraient des expériences biologiques supplémentaires, notamment pour vérifier les structures prédites et tester les fonctions attribuées à certaines molécules d’ARN.
L’article ne fixe aucun calendrier pour une application clinique. Le changement immédiat tient à l’accès : des chercheurs du monde entier peuvent obtenir les ressources d’entraînement, examiner l’implémentation et déterminer si les améliorations rapportées se retrouvent dans leurs propres jeux de données sur l’ARN.
Points clés
- Des chercheurs de l’USTC ont publié structRFM, un modèle de fondation pour l’ARN entraîné sur environ 21 millions de paires de séquences et de structures secondaires.
- Le modèle apprend les régularités des séquences et les relations d’appariement des bases, puis produit des caractéristiques à partir d’une séquence seule.
- MUSES combine plusieurs sources de prédiction structurelle, tandis que le masquage dynamique équilibre les informations structurelles et nucléotidiques pendant l’entraînement.
- Les auteurs font état de bons résultats en classification de l’homologie et d’une amélioration de la prédiction des structures secondaires, notamment lors de tests sur de nouvelles familles d’ARN.
- Zfold, son adaptation à la prédiction des structures tertiaires, a obtenu des résultats jugés comparables à ceux d’AlphaFold3 dans trois collections de référence citées.
- Le jeu de données, les poids du modèle, le code source et les ressources d’évaluation sont accessibles au public pour être réutilisés et permettre la reproduction des travaux.