Le fabricant de téléphones qui vient de changer la donne en matière d’inférence de l’IA
Un lundi matin, à la surprise de l’industrie technologique, Xiaomi a réalisé ce à quoi peu d’observateurs s’attendaient. L’entreprise, surtout connue pour ses smartphones abordables, ses trottinettes électriques et ses purificateurs d’air, a annoncé avoir franchi un cap majeur en matière de vitesse de l’intelligence artificielle. Son nouveau mode d’inférence MiMo-V2.5-Pro-UltraSpeed génère plus de 1 000 tokens par seconde avec un modèle d’un billion de paramètres, et atteint près de 1 200 tokens lors de démonstrations en direct. Il ne s’agit pas d’une version allégée du modèle, mais du modèle phare MiMo-V2.5-Pro dans son intégralité, un système d’IA de pointe qui rivalise avec Claude Opus sur les tests de programmation.
Sommaire
- Le fabricant de téléphones qui vient de changer la donne en matière d’inférence de l’IA
- Ce que représentent vraiment 1 000 tokens par seconde
- Comment Xiaomi a pris de vitesse les géants des puces sur mesure
- Les trois techniques qui propulsent UltraSpeed
- Pourquoi la vitesse ouvre la voie à de nouvelles applications
- Accès, tarifs et publication en open source
- La montée en puissance discrète de Xiaomi dans l’IA
- En bref
Ce qui rend l’annonce stupéfiante, ce n’est pas seulement la vitesse, mais aussi le matériel qui la permet. Xiaomi a obtenu ces résultats avec un seul nœud standard équipé de huit GPU courants, du matériel proposé par tous les grands fournisseurs de services cloud. Pas de silicium conçu sur mesure. Pas de puces spécialisées de la taille d’une assiette. Uniquement des innovations logicielles fonctionnant sur du matériel que les développeurs peuvent louer dès ce soir.
Les paramètres sont les pondérations numériques internes qui déterminent la façon dont un modèle d’IA traite l’information. Un billion de paramètres permet au modèle de reconnaître des schémas extrêmement complexes dans des textes et du code. Les tokens sont les unités de texte que le modèle lit et écrit, soit environ les trois quarts d’un mot chacun. En générer plus de 1 000 par seconde signifie que cet immense cerveau fonctionne à un rythme auparavant considéré comme impossible sans matériel dédié.
Depuis des années, la course à l’accélération de l’inférence de l’IA est dominée par des start-up de puces bien financées, qui conçoivent leurs propres processeurs. Xiaomi vient de démontrer qu’une ingénierie astucieuse sur du matériel standard peut les dépasser toutes. Cette prouesse soulève une question de fond : le matériel spécialisé coûteux est-il nécessaire quand une optimisation logicielle intelligente permet d’obtenir de meilleurs résultats sur une infrastructure accessible ?
Ce que représentent vraiment 1 000 tokens par seconde
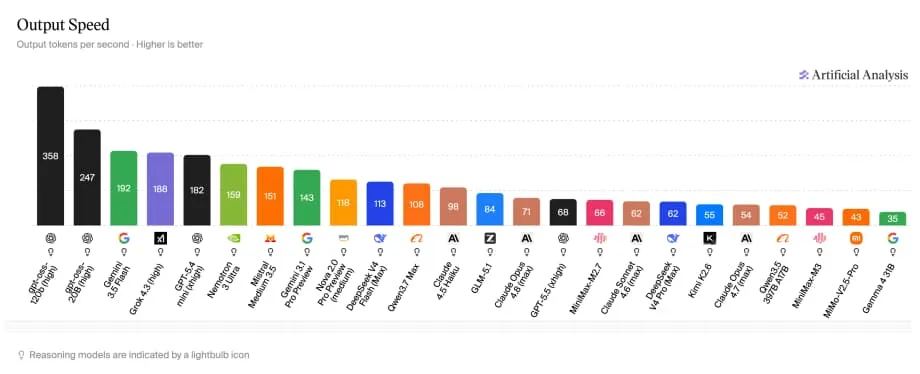
Pour comprendre l’importance de ce chiffre, il suffit de regarder ce que vivent les utilisateurs au quotidien. D’après les données de référence d’Artificial Analysis, GPT-5.5, le modèle qui alimente la plupart des conversations sur ChatGPT, génère environ 68 tokens par seconde. Claude Opus 4.6 tourne autour de 71 tokens par seconde, tandis que le modèle Haiku, plus léger, d’Anthropic atteint 98 tokens par seconde. Gemini Flash de Google va plus vite, avec 192 tokens par seconde. MiMo-V2.5-Pro-UltraSpeed atteint 1 000 tokens par seconde avec un modèle d’un billion de paramètres, soit près de quinze fois plus vite que les chatbots utilisés chaque jour par des millions de personnes.
L’écart entre 68 et 1 000 n’est pas une simple amélioration incrémentale. Il correspond à une tout autre catégorie de performances. Aux vitesses actuelles, les utilisateurs attendent plusieurs secondes qu’un paragraphe s’affiche. À la nouvelle vitesse de Xiaomi, une page entière d’analyse peut apparaître presque instantanément. Pour les développeurs qui utilisent des agents de programmation, l’expérience passe d’échanges différés à une forme de collaboration en temps réel.
Les tokens constituent la monnaie de base des grands modèles de langage. Lorsqu’on saisit une invite, le modèle découpe le texte en tokens pour le traiter. Lorsqu’il répond, il les génère un à un, en prédisant chacun à partir de tout ce qui précède. Plus un modèle génère rapidement des tokens, plus il semble réactif et plus il peut accomplir de tâches dans des délais stricts. La vitesse détermine aussi le nombre de requêtes qu’un serveur peut traiter simultanément, ce qui influe directement sur les coûts et la capacité de montée en charge des entreprises.
La version Flash précédente de MiMo-V2.5-Pro générait déjà des réponses à 150 tokens par seconde, soit environ 110 mots par seconde, plus vite que la vitesse maximale de lecture ou de parole d’un être humain. UltraSpeed repousse considérablement cette limite, avec un débit de génération qui dépasse les capacités cognitives humaines et rend possibles des processus automatisés qui ne l’étaient pas auparavant.
Comment Xiaomi a pris de vitesse les géants des puces sur mesure
Le goulot d’étranglement de la vitesse d’inférence de l’IA a attiré des centaines de millions de dollars d’investissements dans des entreprises qui conçoivent du matériel spécialisé. Cerebras a créé une puce à l’échelle d’une tranche de silicium, à peu près de la taille d’une assiette, dotée de 44 Go de mémoire intégrée pour éliminer les contraintes de bande passante. Cette conception a atteint 969 tokens par seconde, une prouesse impressionnante, mais avec Llama 3.1 405B de Meta, un modèle de 405 milliards de paramètres, soit moins de la moitié de la taille de MiMo-V2.5-Pro. Groq a conçu une architecture de processeur de traitement du langage capable de générer de 300 à 750 tokens par seconde, selon le modèle. Aucun de ces systèmes ne fonctionne sur du matériel cloud standard que les développeurs peuvent louer auprès de fournisseurs comme AWS.
L’approche de Xiaomi inverse complètement ce modèle. En travaillant avec son partenaire d’inférence TileRT, l’entreprise a établi son record grâce à ce qu’elle appelle une co-conception poussée du modèle et du système : une optimisation coordonnée du modèle d’IA et du moteur logiciel qui l’exécute. Résultat : un modèle d’un billion de paramètres plus rapide que les puces spécialisées, sur des GPU courants. Si des tests indépendants confirment ces résultats, cette prouesse montrera que l’innovation logicielle peut surmonter des limites matérielles que beaucoup jugeaient impossibles à dépasser sans puces sur mesure.
Cette avancée a des implications économiques concrètes. Le silicium conçu sur mesure exige des investissements considérables, de longs cycles de conception et une fabrication spécialisée. Les GPU courants profitent des économies d’échelle, d’une large disponibilité et des améliorations constantes apportées par NVIDIA et d’autres fabricants. En résolvant le problème de l’inférence grâce au logiciel, Xiaomi a potentiellement démocratisé l’accès à des vitesses jusqu’ici réservées aux laboratoires bien financés disposant de matériel propriétaire.
La publication du checkpoint FP4-DFlash sur Hugging Face donne une nouvelle dimension à cette démocratisation. Les chercheurs et développeurs du monde entier peuvent désormais examiner, tester et adapter le modèle sous-jacent sans acheter de matériel propriétaire ni obtenir de licence professionnelle. La validation par la communauté permettra de déterminer si ces techniques sont transposables à d’autres modèles et cas d’usage.
Les trois techniques qui propulsent UltraSpeed
Cette percée repose sur trois techniques coordonnées qui fonctionnent de concert. Aucune ne permet à elle seule d’établir ce record de vitesse, mais leur combinaison dépasse le seuil des 1 000 tokens par seconde.
La première est la quantification FP4. La plupart des grands modèles utilisent une précision numérique de 16 ou 8 bits, ce qui signifie que chaque paramètre nécessite deux octets ou un octet de mémoire. Xiaomi compresse les couches expertes, qui représentent la majeure partie du billion de paramètres, pour les ramener à une précision de 4 bits. L’empreinte mémoire et la pression sur la bande passante diminuent, ce qui accélère la circulation des données dans le système. Le risque de la quantification est une perte de qualité : une précision moindre peut dégrader les capacités de raisonnement du modèle. Xiaomi contourne le problème avec une approche ciblée : seules les couches expertes sont compressées, tandis que le reste du modèle conserve sa pleine précision. Selon l’entreprise, la perte de qualité est presque nulle.
La deuxième technique est le décodage spéculatif DFlash. Le décodage spéculatif classique utilise un modèle brouillon plus petit pour deviner rapidement les prochains tokens, puis demande au grand modèle de vérifier ces prédictions en parallèle. DFlash supprime entièrement cette étape séquentielle. À la place, il remplit un bloc entier de positions masquées en un seul passage avant. Dans les tâches de programmation, le grand modèle accepte en moyenne 6,3 des 8 tokens proposés à chaque cycle de vérification. Six tokens avancent donc en une seule étape au lieu d’un, ce qui accélère considérablement la génération.
Le troisième élément est TileRT lui-même, le moteur d’inférence qui maintient l’ensemble du pipeline de calcul en permanence dans le GPU. Les systèmes d’exécution classiques lancent souvent les opérations une par une, créant de petites interruptions. TileRT élimine le temps perdu au lancement de chaque opération et assure une circulation continue des données. Combiné aux pondérations compressées du modèle et à la stratégie de décodage avancée, le moteur maintient des débits jusque-là inaccessibles sur du matériel standard.
Xiaomi appelle cette combinaison une co-conception poussée du modèle et du système, une description qui lui correspond bien. Chaque niveau d’optimisation renforce les autres et produit un résultat supérieur à ce qu’aurait permis chacune de ces techniques prise isolément.
Pourquoi la vitesse ouvre la voie à de nouvelles applications
Les chiffres bruts n’ont aucun intérêt s’ils ne rendent rien de nouveau possible. À 1 000 tokens par seconde, MiMo-V2.5-Pro-UltraSpeed ouvre des perspectives qui restent hors d’atteinte des systèmes plus lents.
Voyons comment les développeurs utilisent actuellement les grands modèles de langage pour les tâches complexes. Face à un problème de programmation difficile, l’utilisateur attend généralement une réponse en espérant qu’elle soit correcte. Avec UltraSpeed, il peut lancer des dizaines de pistes de raisonnement en parallèle dans le même laps de temps, tout en vérifiant et en corrigeant automatiquement les résultats en arrière-plan. Le modèle peut explorer plusieurs solutions à la fois plutôt que de s’engager dans une seule chaîne de raisonnement. Cette capacité transforme fondamentalement l’IA : d’assistant séquentiel, elle devient un outil de résolution de problèmes en parallèle.
Les secteurs soumis à des contraintes strictes de latence pourraient en tirer immédiatement profit. Les systèmes de détection de la fraude doivent évaluer les transactions en quelques millisecondes. La génération de signaux de trading en temps réel ne peut se permettre des délais de plusieurs secondes. Les boucles d’agents autonomes, dans lesquelles les systèmes d’IA observent, décident et agissent rapidement, exigent des vitesses que les chatbots grand public ne peuvent offrir. À 68 tokens par seconde, ces applications se heurtent à des goulots d’étranglement frustrants. À 1 000 tokens par seconde, elles deviennent viables sur une infrastructure cloud standard.
Même dans les tâches de programmation quotidiennes, la vitesse change la manière de travailler. Jusqu’ici, les développeurs fixaient leur écran en attendant la fin de l’inférence. Avec un débit proche ou supérieur à 1 000 tokens par seconde, l’attente disparaît pratiquement. L’interaction passe de la demande suivie d’une attente à une véritable collaboration en temps réel avec un partenaire IA. Les applications médicales qui nécessitent une analyse rapide des données des patients, ainsi que les plateformes d’investissement qui traitent les flux boursiers en direct, bénéficient elles aussi concrètement d’une telle réactivité.
Accès, tarifs et publication en open source
Xiaomi ne garde pas cette technologie derrière une porte verrouillée. L’entreprise a lancé une période d’essai limitée de son API, du 9 au 23 juin 2026. L’accès se fait sur candidature et n’est pas garanti. La priorité est accordée aux entreprises et aux développeurs professionnels ayant des besoins concrets. Les ressources d’inférence à haute vitesse étant limitées, chaque compte peut rejoindre la file d’attente jusqu’à dix fois par jour, pour des sessions limitées à trente minutes. Les sessions inactives pendant plus de cinq minutes seront automatiquement libérées.
La tarification reflète le caractère haut de gamme de cette vitesse. UltraSpeed coûte trois fois plus cher que l’offre MiMo-V2.5-Pro standard, mais génère les tokens environ dix fois plus vite. À titre de comparaison, le MiMo-V2.5-Pro standard est déjà nettement moins cher que Claude Opus : environ 0,43 dollar par million de tokens en entrée et 0,87 dollar par million de tokens en sortie, contre respectivement 5 et 25 dollars pour Opus. Même à un tarif multiplié par trois, l’offre accélérée de Xiaomi reste bien moins chère que de nombreux modèles concurrents de pointe.
Les développeurs qui préfèrent tester directement la technologie peuvent accéder au checkpoint MiMo-V2.5-Pro-FP4-DFlash sous-jacent, publié en open source par Xiaomi sur Hugging Face. TileRT a également publié certains modules sur GitHub. Cette initiative invite la communauté internationale de la recherche à vérifier les résultats, à expérimenter avec l’architecture et à adapter éventuellement ces techniques à d’autres modèles. Les vérifications indépendantes par des tiers n’ont pas encore été largement publiées : les essais de la communauté grâce à ces publications ouvertes apporteront donc une véritable preuve dans les semaines à venir.
La montée en puissance discrète de Xiaomi dans l’IA
Pour la plupart des consommateurs, Xiaomi reste la marque qui vend des appareils électroniques abordables. L’entreprise a vendu des millions de smartphones, de trottinettes électriques et de purificateurs d’air sur les marchés internationaux. Cette image grand public a masqué le développement régulier d’une division d’intelligence artificielle que la majeure partie du secteur n’a remarquée que maintenant.
Dès son lancement en avril, MiMo-V2.5-Pro rivalisait déjà avec Claude Opus sur la plupart des tests de programmation. UltraSpeed ne présente pas un modèle inédit ou édulcoré : il accélère exactement la même intelligence de pointe, déjà en concurrence avec les meilleurs. La marque de téléphones a ainsi développé une capacité d’IA à la hauteur de celle de laboratoires spécialisés, tout en proposant des tarifs dix fois inférieurs.
Si les affirmations concernant la vitesse résistent à un examen indépendant, Xiaomi aura réalisé quelque chose d’extraordinaire, sans les centaines de millions de dollars investis dans le silicium sur mesure par des entreprises comme Cerebras et Groq. L’entreprise aura démontré que l’optimisation logicielle sur du matériel courant peut offrir des performances de tout premier plan. Un tel résultat remettrait en cause les idées reçues sur l’origine des capacités de l’IA et sur les acteurs capables de rivaliser à la pointe du secteur. Un géant chinois de l’électronique grand public vient de rejoindre le cercle des principaux innovateurs en matière d’infrastructures d’IA, avec des GPU standard plutôt que du silicium conçu sur mesure.
En bref
- MiMo-V2.5-Pro-UltraSpeed de Xiaomi génère plus de 1 000 tokens par seconde avec un modèle d’un billion de paramètres, en utilisant uniquement huit GPU courants standard et sans silicium conçu sur mesure.
- Il est environ quinze fois plus rapide que GPT-5.5 et Claude Opus. Cette vitesse repose sur la quantification FP4, le décodage spéculatif DFlash et le moteur d’inférence TileRT.
- Une période d’essai limitée de l’API se déroule du 9 au 23 juin 2026. Elle coûte trois fois plus cher que l’offre MiMo standard, pour une vitesse de génération environ dix fois supérieure. Les entreprises et les développeurs professionnels sont prioritaires.
- Xiaomi a publié le checkpoint FP4-DFlash en open source sur Hugging Face, afin que la communauté puisse vérifier et adapter ces techniques.
- Si elle est confirmée par des vérifications indépendantes, cette percée montrera que l’optimisation logicielle sur du matériel cloud standard peut surpasser les solutions coûteuses fondées sur des puces conçues sur mesure par des entreprises spécialisées dans le matériel d’IA.