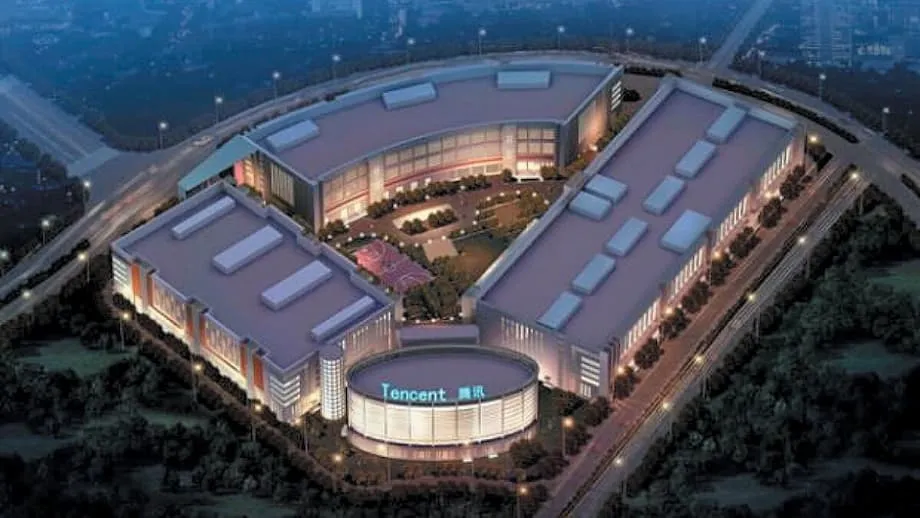
Un pôle central sur le Yangtsé
La Chine transforme une île de 760 acres dans la ville de Wuhu en un vaste ensemble de centres de données, au cœur d’un plan national visant à centraliser la puissance de calcul dédiée à l’intelligence artificielle. Souvent présenté comme le Stargate chinois, le projet fédère des serveurs de Huawei, China Mobile, China Telecom et China Unicom. Il vise à regrouper des installations dispersées au sein d’un réseau unifié, dont les ressources pourront être planifiées et partagées à grande échelle, afin de répondre à la demande croissante en IA et à l’accès limité aux processeurs les plus avancés. Les autorités locales indiquent que les investissements liés au projet atteignent 270 milliards de yuans, soit environ 37 milliards de dollars.
Sommaire
- Un pôle central sur le Yangtsé
- Ce que comprendra l’île de données de 760 acres
- Pourquoi centraliser la puissance de calcul dédiée à l’IA maintenant
- Comment fonctionnera le réseau
- Entraînement à l’ouest, inférence près du littoral
- Huawei UB Mesh et planification à l’échelle des grappes
- Subventions et pénurie de puces
- Qui devrait en bénéficier
- Comparaison avec le projet Stargate américain
- Énergie, refroidissement et réseaux
- Risques, sécurité et gouvernance
- La suite
- Points clés
Le site de Wuhu, appelé localement Data Island, se trouve à proximité de Shanghai, Hangzhou et Nanjing. Cette proximité avec de grands marchés urbains denses est importante pour l’inférence en IA, l’étape où les modèles entraînés répondent aux requêtes ou génèrent du contenu pour les utilisateurs. Des distances plus courtes réduisent la latence et rendent plus réactifs les assistants vocaux, les moteurs de recherche, les contrôles de risque financier, les recommandations commerciales et les services municipaux. La Chine développe ou reconvertit également des installations à Ulanqab, dans le Guizhou et à Qingyang, pour desservir d’autres régions. Ces centres éloignés, souvent situés dans des zones où les terrains sont moins chers et l’énergie abondante, sont destinés à se consacrer à l’entraînement des modèles, l’étape la plus gourmande en calcul du développement de l’IA.
Ce que comprendra l’île de données de 760 acres
Les opérateurs construisent de vastes salles équipées d’accélérateurs, de processeurs, de mémoire, de stockage et de commutateurs à haut débit. Les opérateurs télécoms déploient et gèrent déjà des réseaux de fibre dans la région. Le site pourra donc être relié à grande capacité aux villes voisines et à d’autres pôles de l’intérieur du pays. L’objectif est de pouvoir déplacer les charges de travail au sein du réseau en fonction de l’urgence, du coût et des ressources disponibles, en affectant les ressources inactives d’un site à des tâches exécutées sur un autre. Huawei fait la promotion d’UB Mesh, une technologie qui, selon l’entreprise, peut relier des processeurs répartis dans plusieurs salles, voire plusieurs villes, grâce à des logiciels qui les traitent comme un seul ensemble pour l’entraînement et l’inférence.
Pourquoi centraliser la puissance de calcul dédiée à l’IA maintenant
Pékin veut tirer le meilleur parti de chaque puce présente dans le pays. Ces dernières années, de nombreux accélérateurs dans les provinces éloignées ont été sous-utilisés faute de demande locale, tandis que les entreprises côtières ayant besoin de puissance de calcul ne pouvaient pas facilement accéder à ces capacités. Un réseau national promet de remédier à la situation. En reliant les pôles, les planificateurs espèrent renforcer la redondance en cas de panne, améliorer le taux d’utilisation de l’ensemble des équipements et créer un marché où les capacités excédentaires d’une région pourront être vendues à des acheteurs d’une autre.
Cette stratégie est également dictée par la géopolitique. Selon les estimations d’analystes, les laboratoires américains contrôlent environ les trois quarts de la capacité mondiale de calcul dédiée à l’IA, contre près de 15 % pour la Chine. Les contrôles américains à l’exportation limitent l’accès chinois aux GPU Nvidia les plus avancés et empêchent les principaux fabricants de puces sous contrat de produire ces puces pour des clients chinois. Une meilleure coordination des équipements nationaux devient donc une priorité. La centralisation est le levier politique à disposition, tandis que les projets de puces nationales tentent de rattraper leur retard.
Comment fonctionnera le réseau
Le plan établit une distinction nette entre deux types de travaux liés à l’IA. L’entraînement est l’étape la plus lourde, au cours de laquelle les modèles apprennent à partir de données. Il se prête aux sites éloignés, qui disposent d’une énergie et de terrains moins chers et où des tâches de longue durée peuvent mobiliser des milliers d’accélérateurs pendant des jours ou des semaines. L’inférence est l’étape où les modèles entraînés répondent aux utilisateurs. Elle se rapproche des utilisateurs finaux dans les grandes villes, où la rapidité et la fiabilité comptent davantage que le coût minimal de l’électricité.
Entraînement à l’ouest, inférence près du littoral
Des régions éloignées comme la Mongolie-Intérieure et le Gansu accueillent déjà d’immenses fermes de serveurs, construites pour des services cloud ou Internet. Dans le cadre de la nouvelle stratégie, ces salles sont reconverties pour l’entraînement de modèles, notamment de grands modèles de langage (LLM). Elles sont reliées aux villes côtières par des réseaux de fibre à haute capacité, ce qui permet de copier rapidement les modèles sauvegardés par points de contrôle vers des pôles d’inférence proches de Shanghai, Hangzhou, Guangzhou et d’autres métropoles.
Huawei UB Mesh et planification à l’échelle des grappes
Pour que cela fonctionne, les opérateurs ont besoin d’interconnexions rapides et de logiciels capables de coordonner des milliers de processeurs. UB Mesh se présente comme une infrastructure qui réduit les surcoûts de communication entre accélérateurs répartis dans différentes salles ou sur différents sites. Concrètement, cela suppose des techniques similaires à celles utilisées dans le calcul haute performance, comme l’accès direct à la mémoire à distance et les bibliothèques de communication collective qui synchronisent de nombreuses puces pendant l’entraînement de très grands réseaux neuronaux. Au-dessus de cette infrastructure, des ordonnanceurs peuvent affecter les tâches aux sites où l’électricité est disponible, où les puces adéquates sont inactives ou d’où la latence jusqu’au client final est la plus faible.
Subventions et pénurie de puces
Wuhu propose des subventions couvrant jusqu’à 30 % des achats de puces pour l’IA. Ces aides locales réduisent le coût initial de l’équipement des baies de serveurs, accélèrent le déploiement et permettent aux opérateurs d’atteindre plus rapidement leurs objectifs de densité. Elles atténuent aussi l’écart entre les accélérateurs nationaux et les dernières puces étrangères soumises aux contrôles à l’exportation.
Des fournisseurs nationaux comme Huawei et Cambricon s’efforcent de combler cet écart avec leurs accélérateurs et leurs logiciels de compilation. Les opérateurs doivent encore composer avec un parc hétérogène de générations de matériel, ce qui peut compliquer les entraînements, en particulier lorsque les modèles atteignent des milliers de milliards de paramètres. Cette pression a favorisé l’émergence d’un marché parallèle. Des revendeurs ont tenté de se procurer des systèmes Nvidia soumis à des restrictions et de les acheminer vers la Chine malgré les contrôles. Un intermédiaire basé à Wuhu aurait été associé à des commandes de serveurs de génération Blackwell. Nvidia a contesté l’idée que de tels équipements puissent être déployés à grande échelle en Chine dans le cadre des règles actuelles, estimant que les chaînes d’approvisionnement, les licences et les exigences d’assistance rendent ces affirmations irréalistes.
Qui devrait en bénéficier
À court terme, l’objectif est de permettre aux entreprises des grandes villes d’accéder plus rapidement à l’inférence en IA. Les banques pourront effectuer des évaluations des risques et détecter les fraudes avec une latence réduite. Les détaillants pourront déployer des modèles de recommandation mis à jour presque en temps réel. Les services municipaux pourront utiliser la vision par ordinateur pour gérer la circulation et surveiller les inondations. Les entreprises des médias et du design pourront générer des images et des vidéos plus rapidement. Les start-up pourront louer de la puissance de calcul à l’heure au lieu d’acheter du matériel à l’avance. En reliant les centres d’entraînement de l’intérieur du pays aux pôles d’inférence côtiers, le réseau entend répondre à la fois aux besoins d’expérimentation et aux opérations quotidiennes.
Les opérateurs télécoms se voient aussi confier un rôle qui dépasse la connectivité. Leurs centres de données deviennent des locataires de premier plan à l’ère de l’IA : ils vendent de la puissance de calcul et du stockage aux clients du cloud, tout en fournissant la bande passante interurbaine nécessaire à la synchronisation des modèles. Pour les pouvoirs publics locaux, ces aménagements promettent des emplois pendant les travaux et une base pour des services numériques susceptibles d’attirer de nouvelles entreprises technologiques dans la région.
Comparaison avec le projet Stargate américain
Alors que la Chine mise sur des réseaux construits par étapes, regroupant de nombreuses salles existantes, les États-Unis soutiennent la création d’un ensemble de très grands campus dans le cadre d’un projet appelé Stargate. Les investisseurs et les opérateurs prévoient d’y consacrer jusqu’à 500 milliards de dollars à travers le pays. La feuille de route prévoit près de 7 gigawatts de capacité de centres de données, soit autant que la production d’environ sept grandes centrales nucléaires. Un campus phare à Abilene, au Texas, est conçu pour accueillir plus de 400 000 GPU. Les partenaires du projet affirment que les travaux créeront environ 25 000 emplois sur site au plus fort de la construction.
Le directeur général d’OpenAI, Sam Altman, a résumé les enjeux en soulignant le lien entre les futurs progrès de l’IA et le matériel nécessaire pour les soutenir. Avant de dévoiler de nouveaux sites avec ses partenaires, il a dit tout haut ce qui se dit tout bas sur l’ampleur des moyens nécessaires.
L’IA ne pourra tenir ses promesses que si la puissance de calcul nécessaire est construite.
Les deux stratégies diffèrent dans leur approche. Les États-Unis misent sur de très grands campus construits pour l’occasion, réunissant des centaines de milliers d’accélérateurs derrière une même enceinte. La Chine relie de nombreux pôles, anciens et nouveaux, puis s’appuie sur des logiciels de planification et de nouvelles interconnexions pour les faire fonctionner comme un ensemble plus vaste. L’approche américaine met à l’épreuve les limites de l’approvisionnement en électricité, des terrains et de l’eau dans quelques sites. Le plan chinois répartit les risques et les coûts, tout en acceptant les contraintes liées à l’exploitation de nombreux sites comme un seul système.
Énergie, refroidissement et réseaux
Les grappes modernes d’IA consomment d’immenses quantités d’énergie et produisent de la chaleur qui doit être évacuée en permanence. Le site insulaire de Wuhu nécessitera de nouveaux postes électriques, des lignes de transport et des capacités de secours pour maintenir les systèmes critiques en fonctionnement en cas de panne. La plupart des salles d’entraînement s’appuient sur le refroidissement liquide pour évacuer directement la chaleur des puces et de la mémoire, une évolution par rapport au refroidissement par air courant dans les anciennes salles de serveurs. Les opérateurs chercheront des sources d’eau à proximité ou des systèmes en circuit fermé qui réduisent les prélèvements, et demanderont aux fournisseurs d’améliorer l’efficacité à l’échelle des baies.
Le réseau est tout aussi essentiel. Relier des fermes d’entraînement éloignées à des pôles d’inférence côtiers exige des réseaux de fibre offrant plusieurs térabits de capacité, des transpondeurs optiques capables de transmettre des données sur des centaines de kilomètres et des commutateurs qui gèrent sans goulots d’étranglement le trafic est-ouest au sein des centres de données. Les opérateurs disposant de réseaux nationaux sont avantagés. Ils peuvent mettre en place des itinéraires redondants et gérer l’ingénierie du trafic afin que les mises à jour des modèles et les points de contrôle arrivent à temps, même en cas de maintenance ou d’intempéries.
Risques, sécurité et gouvernance
La centralisation améliore le contrôle et la visibilité, mais concentre les risques. Si trop de capacités dépendent de quelques axes de réseau, les pannes ou les cyberattaques pourraient se propager d’une région à l’autre. Les planificateurs affirment que la redondance est intégrée au système grâce à la mise en réseau de nombreux sites et à la conception d’itinéraires de basculement. Les équipes de cybersécurité devront protéger les poids des modèles, les données des clients et la couche de planification elle-même, qui deviendra une cible de choix dès lors qu’elle contrôlera d’importantes ressources de calcul.
Des contraintes pratiques subsistent. Le recours à de nombreuses salles plus petites ou plus anciennes peut réduire l’efficacité de l’entraînement par rapport à un nouveau campus unique conçu autour d’une même génération de matériel. Les contrats d’approvisionnement en électricité et la stabilité du réseau doivent suivre la croissance. Les décisions d’utilisation des terres, notamment la conversion de terres agricoles, peuvent susciter des critiques si les communautés locales ont le sentiment d’être déplacées ou si la production alimentaire diminue. La transparence sur les indemnisations, l’impact environnemental et la planification du réseau électrique pèsera sur l’acceptation du public.
La suite
Les travaux portent actuellement sur l’agrandissement des premières salles de Wuhu, leur raccordement aux fermes d’entraînement de l’intérieur du pays et le renforcement des logiciels qui planifient les tâches entre les sites. Les pouvoirs publics locaux coordonnent les cycles d’approvisionnement avec les périodes d’octroi des subventions afin d’inciter les premiers clients à réserver des capacités. Les opérateurs télécoms mettent en service de nouveaux itinéraires de fibre et modernisent leurs réseaux centraux pour que les points de contrôle des modèles puissent être rapidement transférés des sites d’entraînement aux pôles d’inférence proches des villes côtières.
Les ingénieurs suivront de près trois facteurs. Premièrement, UB Mesh et les infrastructures similaires permettront-elles d’obtenir les gains annoncés lorsqu’elles s’étendent à plusieurs salles ? Deuxièmement, les accélérateurs, compilateurs et infrastructures logicielles nationaux pourront-ils entraîner et faire fonctionner les modèles les plus récents avec une efficacité acceptable ? Troisièmement, l’approvisionnement en énergie et les capacités de refroidissement pourront-ils suivre la hausse de la densité des baies sans provoquer de baisses de tension ni de tensions sur les ressources en eau ? Les progrès sur ces fronts détermineront la vitesse à laquelle le réseau national pourra s’étendre et sa contribution à la croissance des services d’IA dans le pays.
Points clés
- La Chine construit un réseau centralisé de calcul dédié à l’IA, structuré autour de Data Island, une île de 760 acres à Wuhu, pour un investissement d’environ 37 milliards de dollars.
- Le réseau relie les installations de Wuhu à des pôles de l’intérieur du pays, notamment à Ulanqab, dans le Guizhou et à Qingyang, afin de répartir les tâches d’entraînement et d’inférence.
- Huawei, China Mobile, China Telecom et China Unicom sont les principaux opérateurs ; Huawei fait la promotion d’UB Mesh pour relier les grappes entre elles.
- Wuhu propose des subventions couvrant jusqu’à 30 % des achats de puces pour l’IA afin d’accélérer le déploiement malgré les contrôles à l’exportation visant les GPU étrangers avancés.
- La Chine cherche à améliorer le taux d’utilisation des accélérateurs existants et à vendre les capacités de calcul excédentaires d’une région à l’autre grâce à une couche de planification unifiée.
- Selon des estimations d’analystes, les États-Unis détiennent environ 75 % de la capacité mondiale de calcul dédiée à l’IA, contre près de 15 % pour la Chine.
- Le programme américain Stargate vise près de 7 gigawatts de capacité et jusqu’à 500 milliards de dollars d’investissements, dont un campus au Texas conçu pour accueillir 400 000 GPU.
- Le directeur général d’OpenAI, Sam Altman, affirme qu’il est indispensable de construire suffisamment de capacités de calcul pour que l’IA soit à la hauteur des attentes.
- La centralisation promet de réduire la latence pour les utilisateurs des grandes villes côtières et d’assurer une redondance entre de nombreux sites interconnectés.
- Parmi les difficultés figurent l’approvisionnement en énergie et le refroidissement, la cybersécurité, l’hétérogénéité du matériel entre les sites et les préoccupations du public concernant l’utilisation des terres et de l’eau.